1장
넉 달 치 청구서 전부 공개
돈 이야기부터 한다.
이 책은 AI 챗봇을 직접 만들어 다섯 달 반을 굴린 기록이다. 그런데 그 기록에서 가장 먼저 보여야 할 것은 코드가 아니라 청구서라고 생각한다. 이유는 단순하다. "AI 챗봇을 직접 만들면 도대체 얼마가 드는가"에 대한 정직한 답을, 나는 어디에서도 찾지 못했기 때문이다.
찾을 수 있었던 것은 두 종류였다. 하나는 "API 요금은 100만 토큰당 얼마"라는 단가표다. 이건 사실이지만 답이 아니다. 내가 한 달에 몇 토큰을 쓸지 모르는 사람에게 단가표는 아무것도 알려주지 않는다. 다른 하나는 "AI 서비스로 월 얼마 벌었다"는 수익 인증이다. 이건 답이 아닌 정도가 아니라 질문 자체가 다르다.
그래서 내 것을 공개한다. 실제로 돌아간 서비스의, 실제 사용자가 쓴, 실제 청구 금액이다.
먼저 — 무엇에 대한 청구서인가
숫자를 보기 전에 이 챗봇이 어떻게 생겼는지 한 장으로 놓는다. 이 책의 각 부가 이 그림의 어느 부분인지도 같이 표시했다.
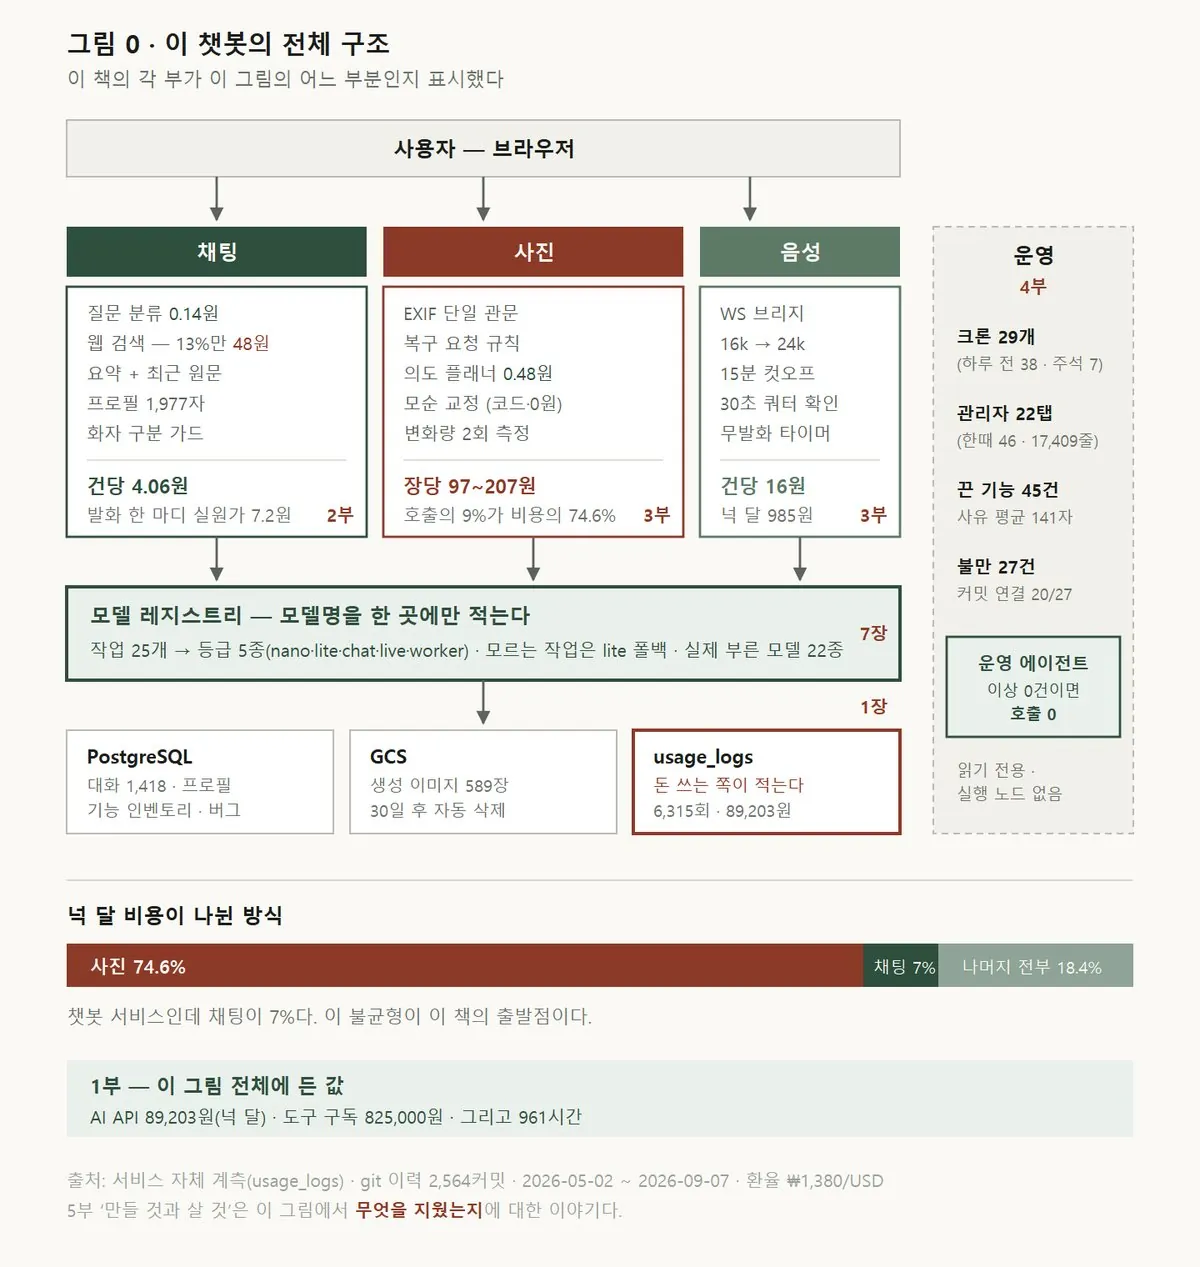
세 갈래로 들어온다 — 채팅, 사진, 음성. 셋은 각각 다른 경로를 지나고, 원가가 서로 백 배 넘게 차이 난다. 그 사실이 이 책의 출발점이고, 이 장의 숫자가 그것을 처음 보여준다.
총액
먼저 한 줄로.
계측 기간  2026-05-02 ~ 2026-09-07 · 128일 (4.2개월)
AI API     6,315회 · $64.64 ≈ 89,203원
월평균     21,214원
넉 달 조금 넘는 기간에 8만 9천 원. 월평균 2만 1천 원이다.
여기서 먼저 짚어야 할 것이 있다. 이 서비스는 다섯 달 반을 돌았는데 청구서는 넉 달 치뿐이다. 처음 6주는 계측을 안 했다. 만들기 바빠서 "나중에 붙이지" 하고 미뤘고, 그 6주의 지출은 지금도 정확히 모른다. 구글 클라우드 청구서에 뭉뚱그려진 총액만 있을 뿐, 무엇이 얼마를 썼는지는 복원할 수 없다.
계측은 소급되지 않는다. 이 책에서 가장 먼저 말하고 싶은 실무 조언이 그것이다. 서비스를 열기 전에 붙여야 할 것은 결제가 아니라 계기판이다.
월별 — 그리고 열여섯 배의 편차
평균은 거의 항상 거짓말을 한다. 월별로 쪼개면 다른 그림이 나온다.
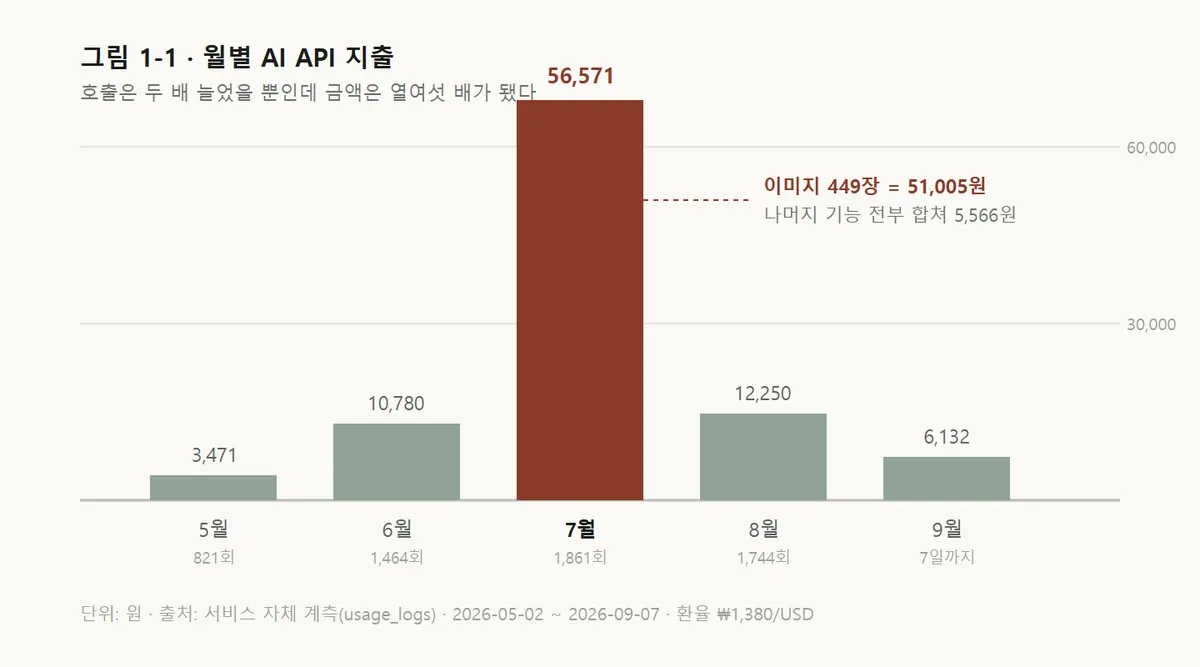
| 월 | 호출 | 지출 |
|---|---|---|
| 2026-05 | 821회 | 3,471원 |
| 2026-06 | 1,464회 | 10,780원 |
| 2026-07 | 1,861회 | 56,571원 |
| 2026-08 | 1,744회 | 12,250원 |
| 2026-09 (7일) | 425회 | 6,132원 |
7월이 5월의 열여섯 배다. 같은 서비스, 같은 사용자 규모인데 그렇다. 호출 횟수는 두 배 남짓 늘었을 뿐인데 금액은 열여섯 배다. 횟수와 금액이 따로 논다는 것 자체가 이 장의 첫 번째 발견이다.
7월 20일, 구글 클라우드에서 알림이 왔다. "예산 ₩80,000의 120%에 도달했습니다." 나는 그날 저녁을 원인 찾는 데 다 썼고, 결론은 허무할 만큼 단순했다. 이미지였다.
7월 한 달에만 이미지가 449장 생성됐고, 그것만 51,005원이었다. 즉 7월 총액 56,571원의 90%가 이미지다. 나머지 모든 기능 — 채팅, 검색, 요약, 음성, 임베딩, 관리자 자동화 — 을 다 합쳐서 5,566원이었다.
이 발견이 이 책 전체의 뼈대가 됐다. AI 서비스의 비용은 균등하게 발생하지 않는다. 한 기능이 나머지 전부를 합친 것의 열 배를 먹는다. 그러니 "AI 비용"을 하나의 덩어리로 관리하면 아무것도 관리하지 못한다.
6,315번을 뜯어보면
무엇이 그 돈을 먹었는지 본다. 넉 달 동안 우리 서비스가 부른 모델은 22종이다.
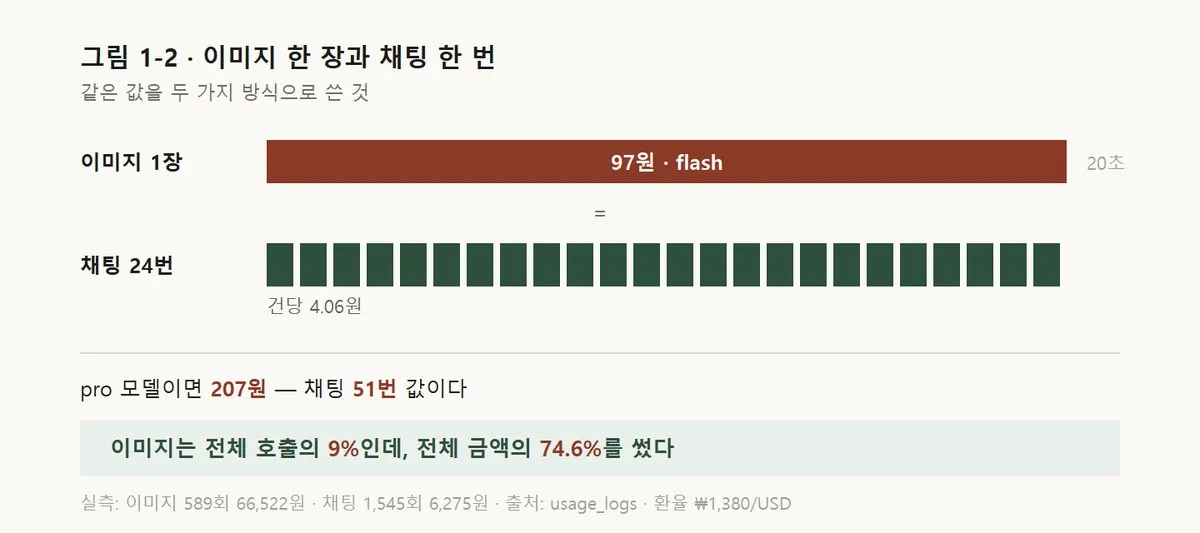
| 항목 | 호출 | 건당 |
|---|---|---|
| 이미지 · pro | 92회 | 207원 |
| 이미지 · flash | 485회 | 97원 |
| 채팅 | 1,545회 | 4.06원 |
이미지 한 장이 채팅 24번 값이다. pro 모델이면 51번이다. 사용자가 챗봇과 한참 대화해도 몇십 원인데, 사진 한 장 만들어 달라고 하면 그 순간 백 원이 나간다.
그래서 전체 비용을 기능별로 나누면 이렇게 된다.
이미지 생성    74.6%   (589회 · 66,522원)
채팅            7.0%   (1,545회 · 6,275원)
나머지 전부    18.4%   (검색·요약·음성·임베딩·관리자 자동화)
챗봇 서비스인데 챗봇이 전체 비용의 7%다. 그리고 이미지를 부른 589회는 전체 호출의 9%밖에 안 되는데 금액의 4분의 3을 먹었다.
사용자 한 마디에 7원
건당 단가보다 정직한 숫자가 하나 더 있다. 사용자가 챗봇에게 한 마디 할 때 실제로 나가는 돈이다.
한 번의 발화에는 모델 호출이 하나만 붙지 않는다. 질문을 분류하고, 필요하면 웹을 검색하고, 대화 성격을 관찰해 프로필을 갱신한다. 이걸 다 합쳐야 실제 원가가 된다.
chat + 분류 + 검색 + 프로필 + 관찰  =  18,856원
사용자 발화                        =  2,616건
                                   ─────────────
                                      발화당 7.2원
한 마디에 7원. 하루에 챗봇과 백 마디를 주고받으면 720원, 한 달이면 2만 원 남짓이다. 상용 챗봇 구독료와 비슷해지는 지점이 하루 백 마디쯤이라는 뜻이다.
이 비교가 공정하지 않다는 것도 같이 적는다. 상용 구독료에는 모델값만 들어 있는 게 아니라 인프라·인력·연구비가 다 들어 있고, 무엇보다 내가 그 챗봇을 만드는 데 쓴 시간이 저 7원에는 빠져 있다. 그 시간의 정직한 계산은 3장에서 따로 한다.
다만 한 가지는 분명하다. 모델을 쓰는 값 자체는 이미 충분히 싸다. 개인이 자기 챗봇을 굴리지 못할 이유는 더 이상 모델 비용이 아니다.
어떻게 세는가
여기까지 읽고 "그래서 이걸 어떻게 재는가"가 궁금하다면 제대로 읽은 것이다. 이 책의 숫자를 믿어도 되는 이유는 계측 구조에 있고, 그 구조는 그대로 가져다 쓸 수 있을 만큼 단순하다.
원칙은 한 줄이다. 모든 AI 호출은 자기 값을 남기고 끝난다. 우리 서비스에는 usage_logs라는 테이블 하나가 있고, 호출이 끝날 때마다 여기에 한 행이 들어간다. 그 행에 들어가는 것은 다섯 가지다.
언제    created_at
누가    user_id
무엇을  model      — 실제로 응답한 모델 ID
어디서  source     — chat / image_gen / grounding / voice_live / ops_agent …
얼마    cost_usd
이 다섯 개면 이 장의 모든 표가 나온다. 월별은 created_at으로 묶고, 기능별은 source로 묶고, 건당 단가는 cost_usd ÷ 행 수다. 관리자 화면의 예산 탭은 이 테이블 위에 얹힌 조회 화면일 뿐이다.
model에 "요청한 모델"이 아니라 "실제로 응답한 모델"을 적는 것이 중요하다. 이미지 모델은 붐빌 때 다른 모델로 넘어가는데(19장), 요청값을 적으면 그 순간 단가가 통째로 틀린다.
그런데 이 단순한 구조에서 나는 같은 실수를 네 번 했다.
네 번 놓친 이야기
이미지 비용이 관리자 화면에서 계속 실제보다 작게 나왔다. 처음엔 환율을 의심했고, 다음엔 조회 쿼리를 의심했다. 진짜 원인은 다른 데 있었다.
새 이미지 모델을 붙일 때마다, 그 모델 ID를 단가표에 추가하는 것을 잊었다. 코드에는 모델별 단가를 적어둔 표가 있는데, 거기 없는 모델은 비용이 0이거나 기본값으로 계산된다. 그래서 실제로는 장당 207원이 나가는 모델이 화면에는 70원으로 찍혔다. 약 3배 과소계상.
더 고약한 것은 이게 조용하다는 점이다. 에러가 안 난다. 화면은 멀쩡히 숫자를 보여주고, 그 숫자가 틀렸다는 신호는 어디에도 없다. 청구서와 대조하기 전까지는 알 방법이 없었다.
네 번째로 같은 일을 겪고 나서야 근본 원인을 고쳤다. 기록하는 위치를 '호출 지점'에서 '비용 발생 지점'으로 옮긴 것이다. 예전에는 이미지를 부르는 코드마다 "이제 로그를 남겨야지" 하고 로그를 적었다. 부르는 자리가 늘어날 때마다 하나씩 빠뜨렸다. 지금은 이미지 생성 함수 자체가 자기 비용을 적고 끝난다. 누가 어디서 부르든 새는 자리가 없다.
로그는 부르는 쪽이 아니라 돈 쓰는 쪽이 적는다.
모델이 22종이라는 말은 단가표에 채워 넣어야 할 줄이 22개라는 뜻이기도 하다. 저 사고가 왜 네 번이나 반복됐는지가 여기서 설명된다.
토큰만 보면 샌다
또 하나. AI 비용을 '토큰 값'으로만 계산하면 큰 항목을 통째로 놓친다.
이미지를 빼고 보면 우리 서비스의 최대 지출 항목은 채팅이 아니다. 웹 검색이다.
| 항목 | 넉 달 지출 |
|---|---|
| 웹 검색 (grounding) | 9,805원 |
| 채팅 | 6,275원 |
| 프로필 분석 | 1,507원 |
| 영상 실험 | 1,380원 |
| 음성 (라이브 + 합성) | 985원 |
챗봇이 최신 정보를 찾을 때 쓰는 검색 기능이 채팅 본체보다 비싸다. 그리고 이건 토큰이 아니라 호출 횟수로 과금된다. 토큰 계산기로는 절대 안 잡힌다.
같은 성질의 항목이 몇 개 더 있다.
| 항목 | 과금 단위 |
|---|---|
| 웹 검색 (grounding) | 호출 횟수 |
| 음성 합성 (TTS) | 글자 수 |
| 임베딩 | 토큰이지만 별도 단가 |
| 영상 생성 | 초 단위 |
이것들은 우리 코드에서 토큰 계산 함수를 타지 않는다. 비용을 직접 계산해 넣어야 하는 항목들이고, 그래서 하나씩 빠졌다가 하나씩 메워졌다.
그런데 계측이 전부가 아니다
앞에서 "청구서가 넉 달 치뿐"이라고 했다. 문제가 하나 더 있다.
usage_logs는 우리 앱 안에서 일어난 호출만 적는다. 그런데 이 프로젝트에는 앱 밖에서 나간 돈이 따로 있었다.
첫째, 영상 실험. 7월에만 약 2만 8천 원을 썼는데, 계측에 잡힌 것은 1,380원(5회)뿐이다. 서버에서 돌린 몇 건만 기록됐고, 나머지 2만 6천 원은 데스크탑에서 개인 인증으로 돌려 usage_logs 밖에 있다. 더 나쁜 것은, 그중 절반은 내가 따로 만들어 둔 지출 원장마저 놓쳐서 클라우드 청구서와 직접 대조하고서야 잡혔다는 점이다.
둘째, AI 팀원의 인건비. 이 서비스를 만든 것은 나 혼자가 아니라 구독형 AI 코딩 도구였고, 그 구독료가 월 15만 원이다. 넉 달이면 60만 원 — 서비스가 쓴 AI API 비용(8만 9천 원)의 일곱 배다.
여기서 이 책의 두 번째 실무 규칙이 나온다.
계기판은 앱 안의 지출만 보고, 청구서는 전부를 본다.
자체 계측은 반드시 필요하다. 앱 안에서 무엇이 돈을 먹는지는 청구서가 절대 안 알려주기 때문이다(청구서는 "Vertex AI: 얼마"라고만 말한다). 하지만 자체 계측만 보면 앱 밖 지출을 통째로 놓친다. 둘 다 봐야 하고, 한 달에 한 번은 대조해야 한다.
화면이 조용하다고 지출이 조용한 게 아니다.
한도를 100만 원으로 걸어두고 안심하고 있었다
이 장을 닫기 전에 부끄러운 것 하나를 더 적는다.
우리 서비스에는 주간 지출 한도 경보가 있었다. 넘으면 관리자 화면에 경고가 뜨는 장치다. 그런데 그 한도가 100만 원으로 걸려 있었다. 실제 주간 지출이 3천 원 안팎인 서비스에서 100만 원 경보는 경보가 아니라 장식이다. 7월에 이미지가 5만 원어치 나갈 때 이 장치는 한 번도 울리지 않았다.
한도를 1만 5천 원으로 내리면서 원칙 하나를 같이 세웠다.
경보의 대상은 '금액이 큰 것'이 아니라 '내가 의도하지 않은 것'이다.
그래서 지금 이미지 생성은 아예 한도 대상에서 제외돼 있다. 내가 사진을 백 장 만드는 건 내가 의도한 일이고, 얼마가 나가든 내 책임이다. 반대로 평소 500원 쓰던 기능이 갑자기 5천 원을 쓰면 그건 열 배여도 알아야 한다. 금액의 크기가 아니라 평소와의 차이가 신호다.
정리하면
이 장에서 확인한 것은 다섯 가지다.
- 넉 달 동안 AI API에 8만 9천 원을 썼다. 월평균 2만 1천 원.
- 그런데 월별 편차가 열여섯 배다. 평균은 관리 도구가 못 된다.
- 비용의 74.6%가 이미지 한 기능이고, 정작 채팅은 7%다. 이미지는 호출의 9%였다.
- 사용자 한 마디의 실제 원가는 7.2원이다.
- 계측 밖에 더 큰 지출이 있다 — 영상 실험과 도구 구독. 그리고 처음 6주는 아예 안 쟀다.
그리고 여기서 자연스러운 질문이 하나 남는다. 비용의 4분의 3이 이미지라면, 이미지를 빼면 이 챗봇은 한 달에 얼마인가?
그 답이 이 책의 제목이다. 다음 장에서 그 숫자를 뜯는다.