13장
음성을 네 번 갈아엎었다
사진 이야기가 끝났다. 이제 목소리다.
사진은 조용히 틀리는 영역이었다. 방향이 뒤집혀도 에러가 안 나고, 결과만 이상해졌다. 목소리는 다르다. 목소리는 되거나 안 되거나이고, 안 되면 즉시 안다. 그런데도 나는 이 영역에서 가장 많이 헤맸다.
먼저 궤적부터 한눈에 놓는다.
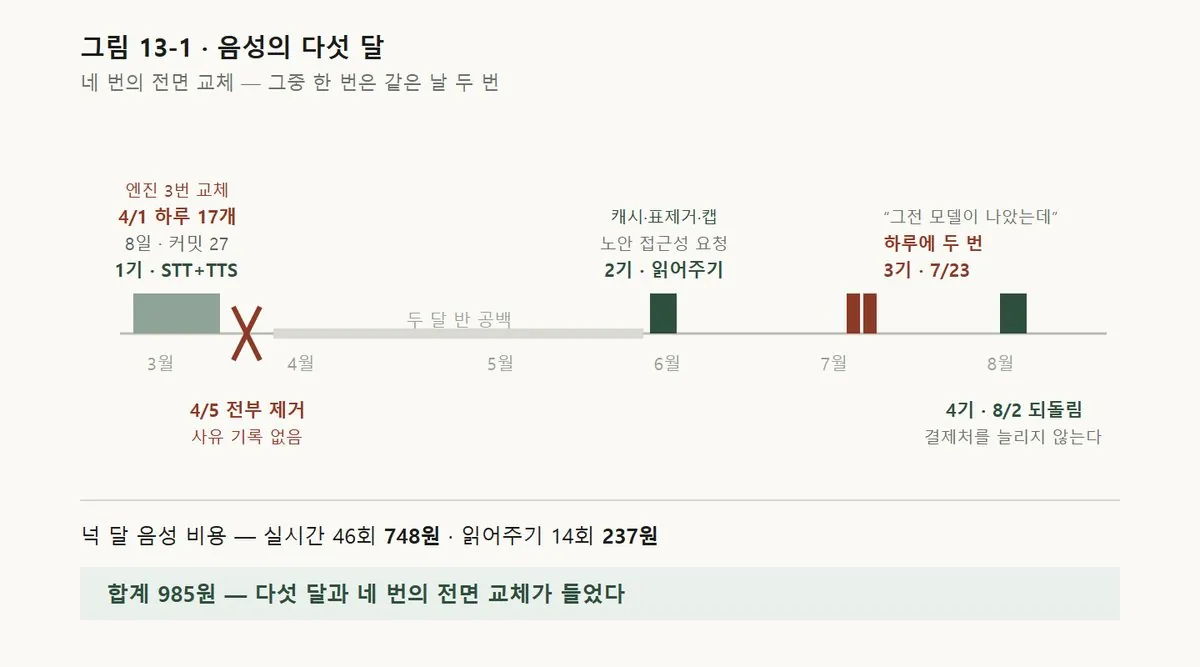
| 시기 | 무엇을 | 결과 |
|---|---|---|
| 3월 말 | 음성 인식(STT)을 붙이려는 일주일 | 8일간 음성 커밋 27개 |
| 4월 5일 | 전부 제거 | 두 달 반 공백 |
| 6월 21일 | 읽어주기(TTS)만 부활 | 다르게 만들었다 |
| 7월 23일 | 실시간 대화 — 하루에 두 번 교체 | |
| 8월 2일 | 다시 되돌림 | 지금 |
다섯 달 동안 네 번 갈아엎었다. 이 장은 그 기록이다.
1기 — 하루에 열일곱 번
3월 말, 챗봇에 음성을 붙이기로 했다. 사용자가 말하면 알아듣고, 답을 소리로 읽어주는 것. 흔한 기능이고 튜토리얼도 많다.
일주일이 이렇게 갔다.
3/30  음성 인식을 Node 서버의 gRPC 브리지로
3/30  → Node 백엔드를 통째로 걷어내고 FastAPI 직결로
3/30  → WebSocket 경로를 /ws/stt 에서 /api/ws/stt 로
        (Cloudflare 캐싱이 앞의 경로를 막고 있었다)
3/30  → 끊긴 연결 자동 재접속
3/31  발화 감지(VAD) + 읽어주는 동안 마이크 음소거
그리고 4월 1일, 하루에 음성 관련 커밋이 열일곱 개 찍혔다. 그날의 목록을 보면 무슨 일이 있었는지 짐작이 간다.
발화 감지 타이머가 무한히 도는 것 차단
발화 감지 게이트 제거 — 즉시 인식되게
20초 하드 리밋 + 재연결
음성 인식을 Deepgram 임시 토큰 직결로
→ Daglo 동기 방식으로
→ 전체를 OpenAI Whisper REST 로
읽어주는 중 마이크 음소거 + 폴백
무한 렌더링 루프 수정
하루에 인식 엔진을 세 번 바꿨다.
이 목록에서 읽어야 할 것은 "부지런했다"가 아니다. 고르는 중이었다는 것이다. 어느 것도 만족스럽지 않았고, 하나를 붙여 보고 문제를 만나고 다음 것으로 넘어가기를 반복했다.
침묵을 말로 바꾸는 문제
그중 하나는 기억해 둘 만하다. Whisper로 옮기고 나서 이상한 일이 생겼다. 아무도 말하지 않았는데 문장이 나왔다.
음성 인식 모델은 오디오를 받으면 무언가를 내놓으려 한다. 조용한 구간을 주면 침묵이라고 답하는 대신 그럴듯한 문장을 지어낸다. 배경 소음이 들어간 몇 초에서 "시청해 주셔서 감사합니다" 같은 문장이 튀어나오는 식이다.
그래서 응답을 상세 형식으로 받아 "말이 없었을 확률" 값을 같이 받고, 그 값이 높으면 결과를 버리도록 필터를 붙였다.
생성 모델은 빈 입력에도 답을 만든다. 침묵을 침묵으로 돌려받으려면 따로 걸러야 한다.
이건 6장의 오염 루프와도 통한다. 모델은 "모르겠다"보다 "그럴듯한 것"을 내놓는 쪽으로 기울어 있고, 그걸 그대로 받으면 시스템이 거짓을 사실로 받아들인다.
그리고 지웠다
4월 5일, 음성 인식과 읽어주기를 전부 걷어냈다. 그 자리에 대화 목록 사이드바와 모바일 UI 개편이 들어갔다.
여드레 동안 스물일곱 개의 커밋을 쏟고, 닷새 뒤에 지웠다.
여기서 정직하게 적을 것이 있다. 왜 지웠는지가 기록에 안 남아 있다. 커밋 제목은 "제거"라고만 말하고, 사유가 없다. 지금 짐작할 수 있는 건 "안 쓰였다"는 것뿐이고, 그 짐작을 뒷받침할 데이터도 남아 있지 않다.
이 책 4부에서 우리 관리자에 접은 기능 45건이 사유 평균 141자와 함께 등록돼 있다는 이야기를 할 것이다. 그 습관은 이 사고 이후에 생겼다.
지운 것에 사유를 안 적으면, 몇 달 뒤에 같은 것을 또 만든다. 실제로 나는 두 달 반 뒤에 다시 만들었다.
2기 — 부활, 그런데 다르게
6월 21일, 읽어주기가 돌아왔다. 이번엔 이유가 명확했다.
한 사용자가 글자가 잘 안 보인다고 했다. 노안이 오면 긴 답변을 화면으로 읽는 게 힘들다. 그래서 답변을 소리로 들을 수 있게 해달라는 요청이었다.
같은 기능인데 설계가 달랐다. 3월에는 "음성 기능이 있으면 좋겠지"였고, 6월에는 "이 사람이 이걸 못 읽는다"였다. 목적이 다르니 만드는 것도 달랐다.
캐시 우선     같은 답변+음색은 두 번 만들지 않는다
              해시로 찾아 재사용 — 다시 듣기는 과금 0

표·코드 제거   음성은 1차원이라 표를 못 담는다
              읽기 전에 정리하고, 표는 "화면에서 봐주세요" 한마디로

일일 캡       무료 공개라 비용 천장이 필요하다
              단, 새로 만드는 것만 세고 다시 듣기는 무제한
"음성은 1차원이라 표를 못 담는다." 이 한 줄이 이 기능의 설계 전부다. 마크다운으로 잘 정돈된 답변을 그대로 읽으면 "파이프 기호 표 시작 항목 파이프…" 같은 소리가 난다. 화면용 구조와 귀용 구조는 다르다.
그리고 캡을 생성에만 걸고 재생에는 안 건 것이 중요하다. 노안 때문에 듣는 사람은 같은 답변을 여러 번 듣는다. 그 사람에게 한도를 걸면 기능의 목적 자체가 사라진다.
한도는 비용이 발생하는 지점에만 건다. 사용자가 반복하는 행동에는 걸지 않는다.
3기 — 하루에 두 번 바꾼 날
7월, 이번엔 읽어주기가 아니라 실시간 대화였다. 말을 걸면 바로 대답하는, 통화 같은 방식이다.
우리는 그때 음색을 고를 수 있는 모델을 쓰고 있었는데 문제가 하나 있었다. 사용자가 무슨 말을 했는지가 기록에 안 남았다. 실시간 음성은 오디오로 오가니, 텍스트로 받으려면 입력 전사를 따로 켜야 한다. 그런데 그 옵션과 음색 선택이 동시에 안 된다고 판단했다.
그래서 7월 23일, 구조를 바꿨다. 내부적으로 음성을 텍스트로 바꾸고 다시 음성으로 만드는 방식으로 옮기니 전사도 남고 자막도 나왔다.
같은 날, 운영자가 이렇게 말했다.
"그전 모델이 나았는데 왜 바꿨나."
바꾼 구조는 안이 STT→TTS라 결이 기계적이었다. 기록은 남는데 대화의 자연스러움이 떨어진 것이다. 그래서 같은 날 두 번째로 다른 회사의 실시간 모델로 갈아탔다. 그건 네이티브 음성 대 음성이면서 입력 전사도 같이 되는 모델이었다.
기록과 자연스러움 중 하나를 고르라고 하면 답이 없다. 둘 다 되는 것을 찾아야 한다.
4기 — 되돌림
그리고 8월 2일, 다시 원래 회사 모델로 돌아왔다. 이유는 기술이 아니었다.
"openai는 내가 또 따로 접속해서 비용 지불하기에는 한계가 있는 거 같아."
1인 개발자에게 결제처가 하나 늘어나는 것은 기술 부채가 아니라 생활 부채다. 카드가 하나 더 걸리고, 잔액을 하나 더 챙겨야 하고, 청구서를 하나 더 대조해야 한다. 이 책 1장에서 말한 "계기판은 앱 안만 본다"는 문제가 결제처 수만큼 늘어난다.
그런데 되돌리면서 하나를 배웠다. 폴백만으로는 부족했다.
우리 코드에는 이미 자동 폴백이 있었다. 한쪽이 안 되면 다른 쪽으로 넘어간다. 그래서 크레딧이 떨어져도 음성은 됐다. 문제는 이거였다.
매 세션마다 먼저 A를 두드린다 → 실패 → B로 넘어간다
                                    ↑
                              여기서 3초를 버린다
사용자는 매번 3초를 더 기다리고 있었다. 그래서 설정으로 아예 B를 기본으로 박았다. 그 뒤로 A를 두드리는 일이 0회가 됐다.
폴백은 안전망이지 설정이 아니다. 어느 쪽을 쓸지 정했으면 그렇게 박아야 한다.
다섯 달의 성적표
지금 이 서비스의 음성 기능이 넉 달간 쓴 돈은 이렇다.
실시간 음성 대화   46회   748원
답변 읽어주기      14회   237원
────────────────────────────
합계                      985원
천 원이 안 된다. 그리고 이걸 만드는 데 다섯 달과 네 번의 전면 교체가 들었다.
이 대비를 어떻게 읽어야 할지 오래 생각했다. 두 가지 답이 있다.
하나 — 안 만들었어야 했다. 사용량이 이렇게 적으면 그 시간을 다른 데 썼어야 한다는 계산이 나온다. 1장의 계산법을 그대로 적용하면 그렇다.
둘 — 이 기능은 사람 수로 재면 안 된다. 읽어주기를 요청한 사람은 화면을 읽기 힘든 사람이었다. 그 사람에게 이 기능은 있고 없고의 문제지 편의의 문제가 아니다. 4장에서 요약 시스템이 1,418개 중 4개를 위한 것이었던 것과 같다.
나는 둘 다 맞다고 생각한다. 그리고 그 둘이 충돌할 때 무엇을 기준으로 정할지는, 이 책이 끝까지 답하지 못하는 질문 중 하나다.
정리하면
- 다섯 달 동안 네 번 갈아엎었다. 그중 한 번은 하루에 두 번이었다.
- 4월 1일 하루에 음성 커밋 열일곱 개 — 부지런한 게 아니라 고르는 중이었다.
- 생성 모델은 빈 입력에도 답을 만든다. 침묵을 걸러내는 필터가 따로 필요하다.
- 4월에 지운 것에 사유를 안 적었고, 두 달 반 뒤에 다시 만들었다.
- 부활할 때는 다르게 만들었다 — 목적이 달랐기 때문이다. "있으면 좋겠지"에서 "이 사람이 못 읽는다"로.
- 음성은 1차원이라 표를 못 담는다. 화면용 구조와 귀용 구조는 다르다.
- 한도는 비용이 나는 지점에만 건다. 반복해서 듣는 행동에는 걸지 않는다.
- 폴백은 안전망이지 설정이 아니다. 매 세션 3초를 버리고 있었다.
- 넉 달 음성 비용은 985원이다. 그리고 그 기능이 꼭 필요한 사람이 있었다.
다음 장은 이 궤적의 기술적인 속살이다. 실시간 오디오를 붙이면서 만난 문서에 없는 함정 다섯 개 — 그중 하나는 사용자가 긴 답변을 듣는 도중에 대화를 끊어버리는 것이었다.