14장
실시간 오디오의 함정 다섯
앞 장이 궤적이었다면 이 장은 속살이다. 실시간 음성 대화를 붙이면서 만난, 문서에 없는 것들이다.
먼저 이 장을 관통하는 한 문장을 먼저 적어둔다. 다섯 개를 다 겪고 나서야 보인 공통점이다.
실시간 오디오의 함정은 전부 '언제'의 문제다.
일반적인 API 호출은 시간이 단순하다. 요청을 보내고, 응답을 받고, 끝난다. 스트림은 다르다. 소리가 도착하는 시각, 재생되는 시각, 우리가 판정하는 시각이 전부 다르다. 그 어긋남에서 문제가 나온다.
구조부터 놓는다. 실시간 음성은 브라우저와 모델이 직접 붙지 않고, 그 사이에 우리 서버가 낀다. 다섯 함정은 전부 그 가운데 자리에서 생긴 일이다.
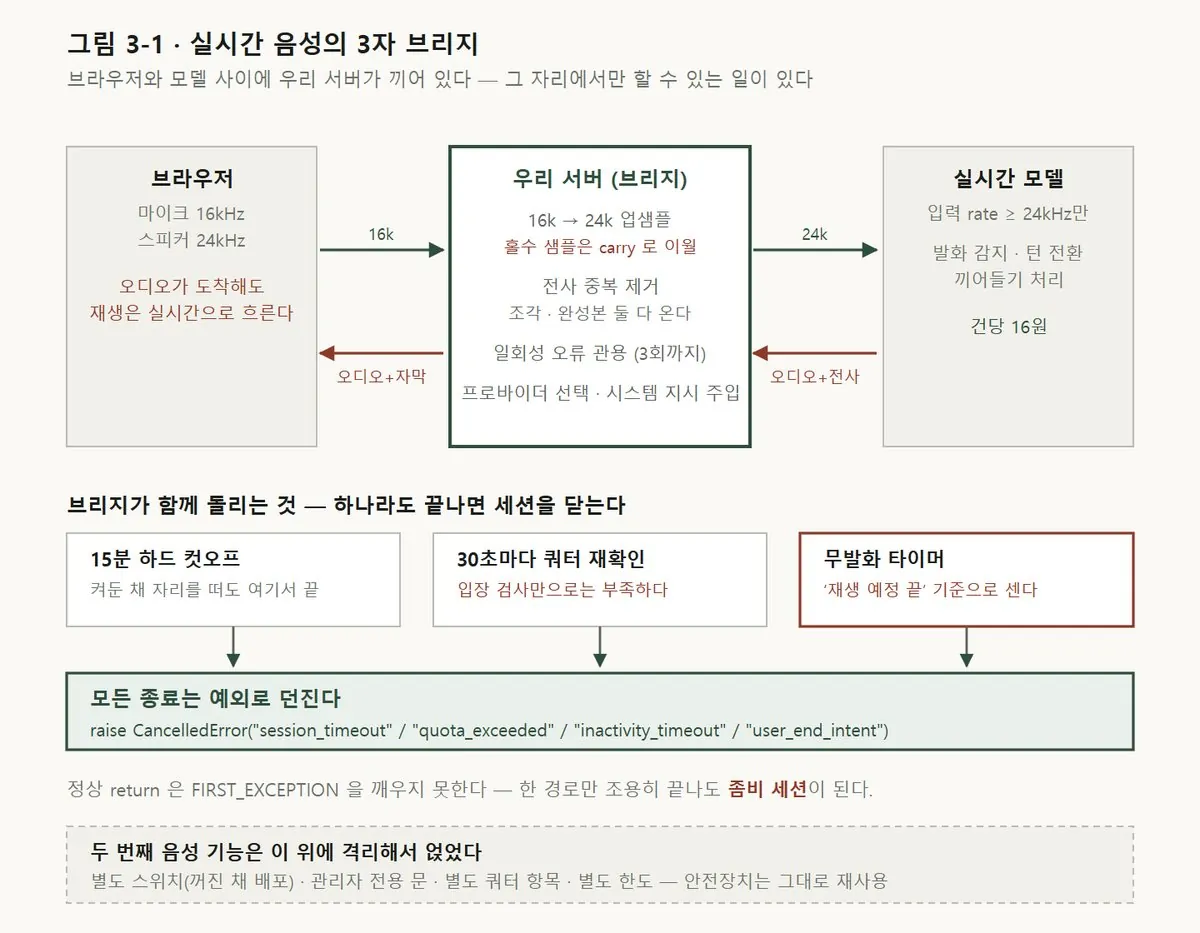
가운데에 서 있으면 비용이 든다 — 변환도 해야 하고 중복도 걸러야 한다. 대신 그 자리에서만 할 수 있는 일이 있다. 15분 컷오프도, 쿼터 재확인도, 프로바이더 교체도 여기서만 가능하다. 13장에서 네 번 갈아엎을 수 있었던 것도 브라우저가 이 브리지만 알고 있었기 때문이다.
함정 ① 마이크의 소리를 그대로 보낼 수 없다
첫 번째는 시작부터 막았다. 연결하고 오디오를 보내니 거부당했다.
integer_below_min_value
원인은 샘플레이트였다. 브라우저 마이크는 16kHz로 소리를 준다. 그런데 그 실시간 API는 24kHz 이상만 받는다. 그래서 오디오가 아니라 숫자 하나 때문에 아예 연결이 안 됐다.
해법은 중간에서 변환하는 것이다. 16kHz를 24kHz로 올리려면 2개의 샘플을 3개로 늘려야 한다. 두 값 사이에 평균을 하나 끼워 넣으면 된다.
for i in range(0, usable, 2):
    a, b = samples[i], samples[i + 1]
    out.append(a)
    out.append((a + b) // 2)    # 사이에 하나 끼워 넣는다
    out.append(b)
여기까지는 교과서다. 실제 함정은 그 다음이었다.
오디오는 덩어리(청크)로 계속 흘러온다. 그런데 청크의 샘플 개수가 항상 짝수라는 보장이 없다. 홀수면 마지막 한 샘플이 짝을 못 찾는다. 그냥 버리면 청크 경계마다 미세한 어긋남이 쌓이고, 그게 딸깍거리는 소리가 된다.
그래서 짝을 못 찾은 샘플을 버리지 않고 다음 청크로 넘긴다.
carry[:] = buf[usable * 2:]      # 남은 1샘플을 이월
...
buf = bytes(carry) + pcm         # 다음 청크 앞에 붙인다
carry라는 이름의 변수 하나가 하는 일이 그것이다.
스트림 처리에서는 "이번 덩어리에서 처리 못 한 것"을 다음으로 넘길 자리가 반드시 필요하다.
함정 ② 같은 말이 두 번 온다
연결이 되고 대화가 시작됐다. 그런데 사용자 발화 자막이 두 번씩 찍혔다.
원인은 프로토콜의 친절함이었다. 음성을 텍스트로 바꾸는 결과가 두 가지 형태로 온다.
input_audio_transcription.delta      조금씩 실시간으로
input_audio_transcription.completed  다 끝나고 완성본으로
둘 다 온다. 실시간 자막을 위해 조각들을 이어 붙이고 있는데, 마지막에 완성본이 또 오니 같은 문장이 한 번 더 붙는다.
고침은 플래그 하나다.
saw_input_delta = False   # 이번 턴에 조각을 받았는가
...
# completed 가 오면: 조각을 받았으면 '교체'만, 못 받았으면 '추가'
조각을 받았다면 완성본은 더하는 게 아니라 갈아치우는 것으로 쓴다. 조각을 못 받은 경우(짧은 발화 등)에만 완성본을 그대로 쓴다.
스트리밍 API는 같은 내용을 여러 형태로 준다. 어느 것을 진실로 삼을지 정하지 않으면 중복된다.
함정 ③ 소리는 도착하자마자 들리지 않는다
이게 다섯 중 사용자에게 가장 직접 닿는 함정이었다.
우리에겐 무발화 타이머가 있다. 사용자가 오래 말이 없으면 세션을 끊는 장치다. 켜놓고 잊어버리면 돈이 나가니 필요하다.
그런데 사용자들이 긴 답변을 듣는 도중에 통화가 끊긴다고 했다. 말을 안 한 것도 아닌데, 정확히는 AI가 길게 말하는 중에 끊겼다.
원인은 이랬다. 오디오는 재생 속도보다 훨씬 빨리 도착한다.
20초짜리 답변 오디오  →  2초 만에 전부 도착 (burst)
                          ↓
                      사용자는 앞으로 20초 동안 듣는다
                          ↓
                      그동안 우리 타이머는 "18초째 아무 말 없음"으로 센다
서버 입장에서는 데이터를 다 보냈으니 조용해진 것이고, 사용자 입장에서는 아직 듣고 있는 중이다. 그 어긋남만큼 타이머가 잘못 흐른다.
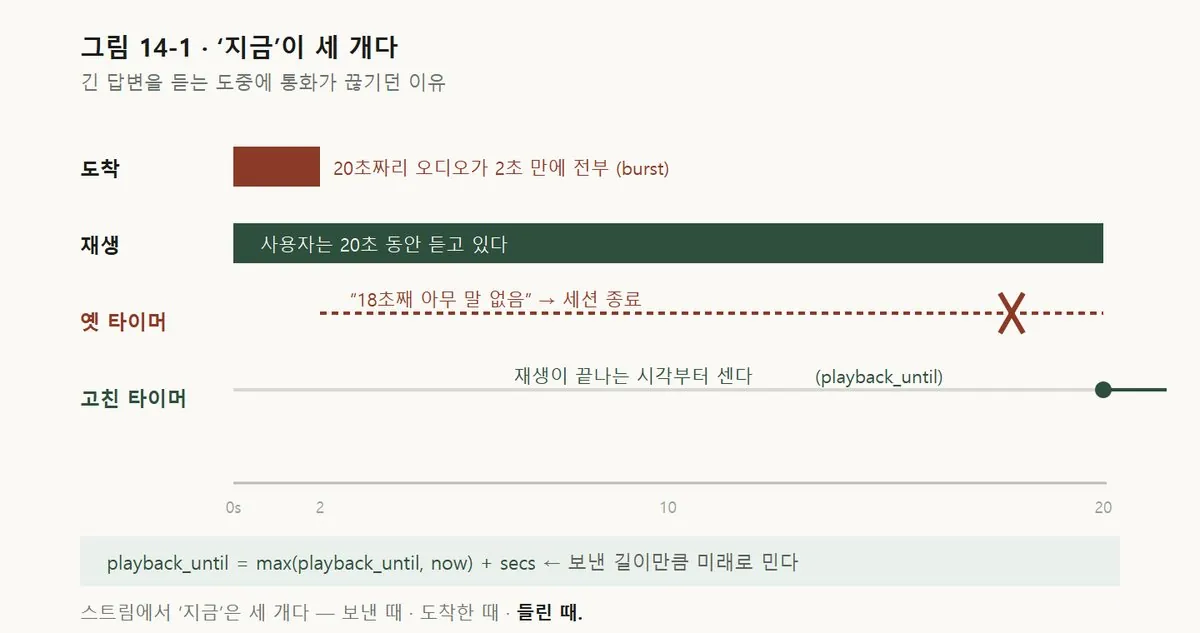
그래서 기준을 바꿨다. "마지막으로 무언가 도착한 시각"이 아니라 "클라이언트에서 재생이 끝날 예상 시각"을 기준으로 잰다.
playback_until = session_start   # 재생이 끝나는 예상 시각
...
playback_until = max(playback_until, now) + secs   # 보낸 오디오 길이만큼 밀어준다
오디오를 보낼 때마다 그 길이만큼 미래로 밀어둔다. 무발화 판정은 그 시각 이후부터 센다.
같은 이유로, 사용자가 "이제 그만"이라고 말해서 세션을 닫을 때도 작별 인사가 재생될 시간만큼 기다렸다가 끊는다. 안 그러면 작별 인사가 도중에 잘린다.
스트림에서 '지금'은 세 개다 — 보낸 때, 도착한 때, 들린 때. 판정은 사용자가 겪는 시각으로 해야 한다.
함정 ④ 정상적으로 끝나면 아무도 안 깨어난다
이건 언어의 함정에 가깝다.
실시간 브리지는 여러 개의 일을 동시에 돌린다. 사용자 마이크를 읽는 일, 서버 오디오를 받는 일, 15분을 세는 일, 쿼터를 확인하는 일. 이 중 하나라도 끝나면 전부 정리하고 세션을 닫아야 한다.
파이썬에서 이렇게 쓴다.
await asyncio.wait(tasks, return_when=asyncio.FIRST_EXCEPTION)
"첫 번째 예외가 나면 깨어난다"는 뜻이다. 그리고 여기 함정이 있다.
어떤 일이 예외 없이 정상적으로 끝나면, 이 줄은 안 깨어난다.
사용자가 연결을 끊어서 오디오를 읽는 일이 조용히 return했다고 하자. 예외가 아니니 대기는 계속되고, 나머지 일들은 계속 돌고, 세션은 닫히지 않은 채로 남는다. 좀비다. 그리고 그 좀비는 계속 비용을 쓸 수 있다.
고침은 규칙 하나다. 끝낼 이유가 생기면 반드시 예외를 던진다.
raise asyncio.CancelledError("user_end_intent")
raise asyncio.CancelledError("session_timeout")
raise asyncio.CancelledError("quota_exceeded")
raise asyncio.CancelledError("inactivity_timeout")
정상 종료도, 시간 초과도, 한도 초과도, 무발화도 전부 예외로 낸다. 문자열에 이유를 담아서.
"모두가 지켜보는 신호"를 정했으면, 모든 종료가 그 신호를 내야 한다. 한 경로만 조용히 끝나도 시스템은 안 깨어난다.
함정 ⑤ 한 번의 오류로 통화가 죽는다
마지막은 관용의 문제다.
실시간 대화에는 이런 순간이 있다. AI가 인사를 시작하는데 사용자가 동시에 말을 건다. 그러면 서버는 "이미 응답을 만들고 있는데 또 요청이 왔다"며 오류 이벤트를 보낸다.
이건 고장이 아니다. 사람 사이의 대화에서도 늘 일어나는 일이다. 그런데 우리 코드는 오류 이벤트를 받으면 세션을 닫고 있었다. 사용자 입장에서는 인사말에 대꾸했더니 전화가 끊긴 것이다.
그래서 오류를 세되, 바로 죽이지 않는다.
err_count = 0   # 일회성 프로토콜 오류 관용
...
elif t == "error":
    err_count += 1
    logger.error(...)
    if err_count >= 3:      # 세 번 쌓이면 그때 종료
        ...
한 번은 사고, 세 번은 고장. 이 구분이 없으면 실시간 시스템은 너무 예민해서 못 쓴다.
드물게 나는 오류는 무시하고, 반복되는 오류는 죽인다. 둘을 같은 코드로 다루면 안 된다.
그리고 세 겹의 안전장치
함정 다섯 개 말고, 이 기능에 처음부터 넣어둔 것이 있다. 실시간 음성은 켜둔 채로 잊어버리면 돈이 계속 나가는 유일한 기능이라서다.
15분 하드 컷오프    실수로 켜두고 자리를 떠도 여기서 끝난다
30초마다 쿼터 재확인  핸드셰이크 때만 보면, 긴 세션 중에 한도를 넘어도 모른다
무발화 타이머        말이 없으면 정리한다 (③의 기준으로)
두 번째가 나중에 추가된 것이다. 처음에는 연결할 때 한 번만 한도를 확인했는데, 한 세션이 15분이면 그 사이에 한도를 넘길 수 있다. 시작할 때 통과했다는 이유로 끝까지 열어두면 안 된다.
긴 세션에서는 입장 검사만으로 부족하다. 세션 중에도 다시 물어야 한다.
새 기능은 격리해서 붙인다
이 브리지 위에 두 번째 음성 기능을 얹을 때, 기존 것을 건드리지 않고 통째로 갈랐다. 그 방식을 적어둔다.
별도 기능 스위치     배포 즉시 꺼진 상태로 나간다
별도 관리자 전용 문   검증 단계에는 나만 들어간다
별도 쿼터 항목       기존 음성 한도와 합산되지 않는다
별도 일일 한도       짧은 명령 위주라 5분
같은 안전장치        15분 컷오프·쿼터 재확인은 그대로 재사용
꺼진 채로 배포하고, 나만 켜서 확인하고, 그 다음에 연다. 그리고 새 기능이 기존 기능의 한도를 잡아먹지 않게 계량기를 따로 단다.
이 방식의 값은 되돌리기가 쉽다는 데 있다. 문제가 생기면 스위치 하나를 끄면 되고, 기존 음성은 아무 영향을 받지 않는다.
정리하면
실시간 오디오의 함정 다섯은 이랬다.
| 함정 | 교훈 | |
|---|---|---|
| ① | 마이크 16kHz를 API가 거부 | 스트림에는 넘길 자리(carry)가 필요하다 |
| ② | 전사가 조각과 완성본 둘 다 옴 | 무엇을 진실로 삼을지 정한다 |
| ③ | 오디오가 재생보다 빨리 도착 | 판정은 사용자가 겪는 시각으로 |
| ④ | 정상 종료는 대기를 안 깨움 | 모든 종료가 같은 신호를 내야 한다 |
| ⑤ | 일회성 충돌로 세션 사망 | 한 번은 사고, 세 번은 고장 |
그리고 이 다섯이 전부 '언제'의 문제였다. 요청과 응답이 한 쌍인 API에서는 생기지 않는 종류의 버그이고, 그래서 문서에도 잘 안 적혀 있다. 직접 붙여 보고 실측해야 나온다.
다음 장은 이 영역에서 가장 부끄러운 이야기다. 나는 이 실시간 음성의 구조를 한 번 통째로 바꿨는데, 그 결정의 근거가 된 측정이 틀렸다. 그리고 그걸 두 달 뒤에 알았다.