15장
내 측정이 틀렸다
3부는 계측의 부였다. EXIF를 찾은 것도, 무변화 10%를 센 것도, 누적 드리프트를 잡은 것도 전부 재봤기 때문에 알았다.
이 장은 그 반대편이다. 재봤는데 틀렸던 이야기이고, 이 책에서 가장 부끄러운 장이다.
7월의 판단
13장에서 실시간 음성 구조를 하루에 두 번 바꿨다고 썼다. 그 첫 번째 전환의 근거가 이것이었다.
당시 우리는 사용자가 무슨 말을 했는지 기록에 남기고 싶었다. 실시간 음성은 오디오로 오가니, 텍스트를 받으려면 입력 전사 옵션을 켜야 한다. 그런데 그 옵션을 켜면 음색 선택이 안 먹는 것 같았다.
그래서 나는 이렇게 결론 내렸다.
이 모델은 음색과 입력 전사가 배타적이다. 둘 중 하나만 된다.
기록을 포기할 수는 없으니 음색 쪽을 포기하기로 하고, 내부적으로 음성을 텍스트로 바꿨다가 다시 음성으로 만드는 구조로 옮겼다. 그 구조는 전사가 당연히 남는다.
대신 대화의 결이 기계적이 됐고, 운영자가 같은 날 "그전 모델이 나았는데 왜 바꿨나"라고 했고, 그래서 또 한 번 갈아탔다. 13장에서 '하루에 두 번'이라고 쓴 그 사건이 여기서 시작됐다.
8월, 다시 재봤다
두 달 뒤 다른 일로 이 영역을 다시 건드리게 됐다. 이번엔 제대로 재보기로 했다.
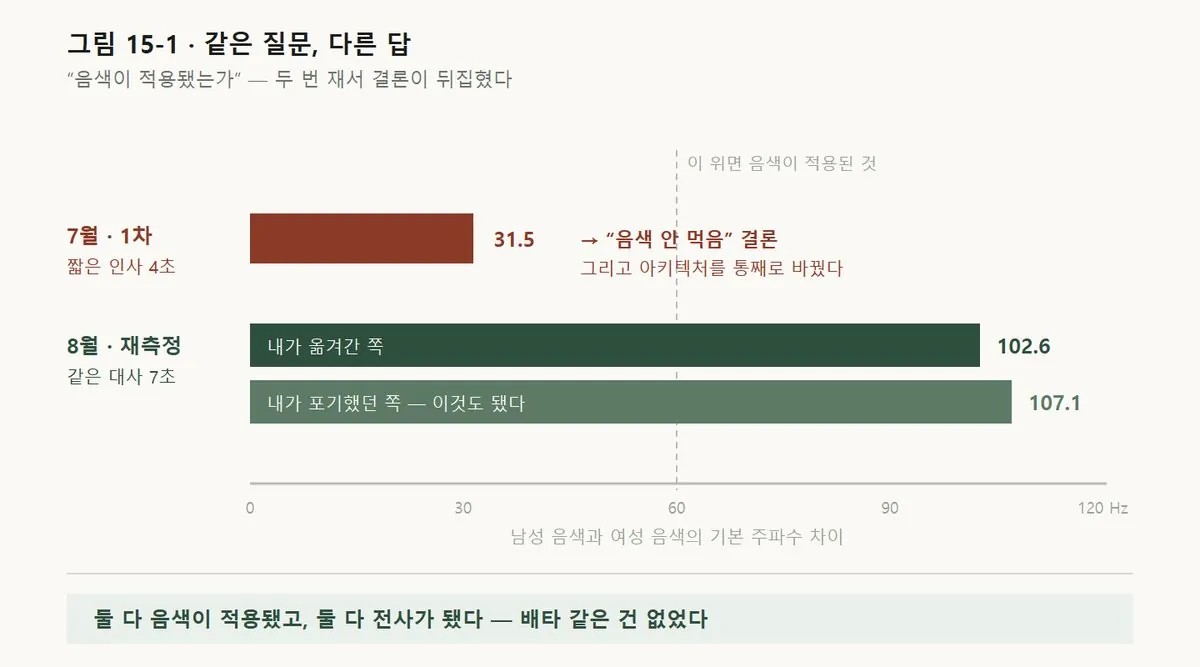
방법은 이랬다. 각 모델에 남성 음색과 여성 음색으로 같은 문장을 말하게 하고, 나온 오디오의 기본 주파수(F0) 를 잰다. 음색이 실제로 적용됐다면 남성과 여성의 F0가 크게 다를 것이고, 안 먹었다면 비슷할 것이다.
결과가 이랬다.
| 모델 | 남성 음색 | 여성 음색 | 차이 | 입력 전사 |
|---|---|---|---|---|
| A (내가 옮겨간 쪽) | 150.0 Hz | 252.6 Hz | 102.6 | ✅ 됨 |
| B (내가 포기한 쪽) | 123.7 Hz | 230.8 Hz | 107.1 | ✅ 됨 |
둘 다 음색이 적용됐고, 둘 다 전사가 됐다.
배타 같은 건 없었다. 나는 있지도 않은 제약을 근거로 구조를 통째로 바꿨고, 그 결과 대화가 기계적이 됐고, 그걸 되돌리느라 같은 날 또 바꿨다.
왜 틀렸나
원인을 찾는 데는 오래 걸리지 않았다. 7월의 측정이 4초짜리 인사말로 재본 것이었다.
7월 1차   짧은 인사 (약 4초)     남녀 차이  31.5 Hz   → "음색 안 먹음"
8월 2차   같은 대사 (약 7초)     남녀 차이 102.6 Hz   → 뒤집힘
기본 주파수는 발화가 짧으면 못 믿는다. 인사말처럼 짧은 소리에는 억양의 흔들림이 크게 섞이고, 그 흔들림이 음색 차이를 덮는다. 4초는 그 흔들림을 평균 내기에 너무 짧았다.
그리고 더 중요한 것은, 7월에 두 모델을 다른 문장으로 쟀다는 점이다. 길이도 달랐고 내용도 달랐다. 그러면 비교 자체가 성립하지 않는다.
비교는 같은 조건에서만 성립한다. 같은 대사, 같은 길이로 재지 않으면 무엇을 비교했는지 알 수 없다.
당연한 말인데, 나는 당연한 것을 안 지키고 아키텍처를 바꿨다.
표본 하나로 정책을 정하지 않는다
이 사고 뒤에 세운 규칙이 하나다. 사실 비슷한 교훈을 그 전달에도 겪었다.
7월 말, 이미지 모델을 더 좋은 것으로 바꿀지 고민했다. 한 장을 만들어 보고 "이게 나은가?" 하다가 멈췄다. 한 장으로는 알 수 없다. 그래서 여러 장을 같은 조건으로 만들어 비교했고, 결론은 "교체 안 함"이었다.
그때 얻은 규칙이 음성에서 필요했는데, 나는 그걸 음성에는 적용하지 않았다.
표본 하나로 모델 정책을 정하지 않는다.
이건 AI 기능을 다루는 사람이라면 계속 마주치는 유혹이다. 모델을 바꿔 한 번 돌려 보면 결과가 나오고, 그 결과가 좋으면 "이게 낫다"고 말하고 싶어진다. 그런데 생성 모델은 같은 입력에도 다른 출력을 낸다. 한 번의 결과는 그 모델의 성질이 아니라 그날의 운이다.
그리고 — 목록도 못 믿는다
재측정을 하면서 하나를 더 봤다. 이건 예상 밖이었다.
그 서비스가 제공하는 사용 가능한 모델 목록을 조회하면, 두 모델 중 하나만 나온다. 그런데 목록에 없는 쪽으로 연결하면 정상적으로 동작한다.
목록에 있다   →  쓸 수 있다는 보장이 아니다
목록에 없다   →  못 쓴다는 뜻이 아니다
양방향으로 못 믿는다. 목록을 보고 "이건 없으니 안 되겠네"라고 판단하면 되는 것을 포기하게 되고, "목록에 있으니 되겠네"라고 하면 안 되는 것에 시간을 쓴다.
그래서 지금은 직접 연결해 본다. 목록은 후보를 좁히는 데만 쓰고, 되는지 안 되는지는 실제로 붙여 봐야 안다.
이름에서 설정을 유도하면 조용히 꺼진다
이 장을 쓰면서 코드를 다시 보다가 위험한 것을 하나 발견했다. 재측정 결과대로 모델을 바꾸려면 설정값 하나만 고치면 될 것 같았는데, 그러면 자막이 조용히 꺼진다.
코드가 이렇게 되어 있었다.
INPUT_TRANSCRIPTION_OK = "native-audio" not in LIVE_MODEL
모델 이름에 특정 문자열이 있으면 입력 전사를 끈다. 7월의 잘못된 결론("이 계열은 전사가 안 된다")이 코드에 규칙으로 굳어 있었던 것이다.
그래서 모델만 바꾸면 자막이 사라지고, 대화 기록이 안 남고, "말로 종료" 기능도 죽는다. 그리고 에러는 안 난다. 그냥 자막이 안 뜰 뿐이다.
설정을 다른 값에서 유도하면, 그 값을 바꾼 사람은 무엇이 함께 바뀌는지 모른다.
7장에서 모델명을 한 곳에 모은 이야기를 했다. 그건 좋은 설계였는데, 그 모델명에서 다른 동작을 파생시키는 순간 한 곳에 모은 이득이 사라진다. 모델을 바꾸는 것이 더 이상 "한 줄 바꾸기"가 아니게 되기 때문이다.
그래서 지금은 안 바꿨다
재측정으로 "둘 다 된다"는 것을 알았지만, 실제로 모델을 옮기지는 않았다. 이유가 셋이다.
첫째, 검증되지 않은 잔여 위험이 있다. 텍스트로 대화를 시작하면 응답이 정상인데, 실시간 오디오를 흘려넣는 경로에서는 응답 오디오가 0초로 나오는 현상을 봤다. 내 테스트 코드의 문제일 수도 있고 아닐 수도 있다. 확정 못 한 것을 확정된 것처럼 다루지 않기로 했다.
둘째, 파생 규칙을 같이 고쳐야 한다. 위의 그 줄이다.
셋째, 그리고 이게 결정적인데 — 무엇이 더 자연스러운지는 내가 못 정한다.
귀로만 판정할 수 있는 것
3부의 마지막 문단으로 이 이야기를 쓰고 싶다.
이 책의 대부분은 "재라"고 말한다. 감으로 판단하지 말고, 분포를 보고, 임계를 찾고, 숫자로 확인하라고. 나는 그게 옳다고 생각한다.
그런데 음성의 자연스러움은 F0로 못 잰다. 남녀 F0 차이가 102.6이든 107.1이든, 그건 "음색이 적용됐는가"에 대한 답이지 "어느 쪽이 사람 같은가"에 대한 답이 아니다.
그래서 재측정 뒤에 한 일은 결정이 아니라 샘플 만들기였다. 같은 대사, 같은 7초로 네 개(두 모델 × 두 음색)를 만들어 운영자에게 전달하고, 들어 보고 정하시라고 했다.
숫자로 답할 수 있는 질문과 귀로만 답할 수 있는 질문을 갈라야 한다.
이걸 안 가르면 두 가지 실패가 생긴다. 귀로 정할 것을 숫자로 정하면 나처럼 아키텍처를 잘못 바꾸고, 숫자로 정할 것을 귀로 정하면 12장의 임계값을 감으로 잡게 된다.
정리하면
- 7월의 결론이 틀렸다. "음색과 전사는 배타적"이라는 제약은 없었다.
- 원인은 4초짜리 인사말로 쟀기 때문이다. 기본 주파수는 발화가 짧으면 못 믿는다.
- 그리고 두 모델을 다른 문장으로 쟀다. 비교는 같은 조건에서만 성립한다.
- 표본 하나로 모델 정책을 정하지 않는다. 생성 모델의 한 번 결과는 성질이 아니라 그날의 운이다.
- 모델 목록은 양방향으로 못 믿는다. 있다고 되는 것도, 없다고 안 되는 것도 아니다.
- 이름에서 설정을 유도하면 그 이름을 바꾼 사람이 무엇이 함께 꺼지는지 모른다. 에러도 안 난다.
- 확정 못 한 것은 확정된 것처럼 다루지 않는다. 그래서 아직 안 바꿨다.
- 숫자로 답할 질문과 귀로 답할 질문은 다르다.
여기까지가 3부다. 사진에서는 조용히 틀리는 값을 찾았고, 음성에서는 내가 틀리게 재고 있었다는 것을 찾았다.
4부는 다른 이야기다. 지금까지는 무엇을 만들었는가였고, 이제부터는 만든 것을 혼자 어떻게 지켰는가다. 첫 장은 관리자 탭이 마흔여섯 개가 된 이야기로 시작한다.