4장
41,294자를 4,518자로
챗봇을 만들면 첫 주에 동작한다. 문제는 셋째 달에 온다.
대화가 길어지기 때문이다. LLM은 기억이 없다. 매번 "지금까지 우리가 무슨 이야기를 했는지"를 통째로 다시 알려줘야 다음 말을 할 수 있다. 그래서 대화가 길어질수록 매 턴마다 보내는 짐이 무거워진다.
본론에 들어가기 전에, 2부 전체의 지도를 먼저 놓는다. 답변 한 번에 무엇이 조립되는지의 그림이고, 4장부터 8장까지는 이 그림의 조각을 하나씩 만든 이야기다.
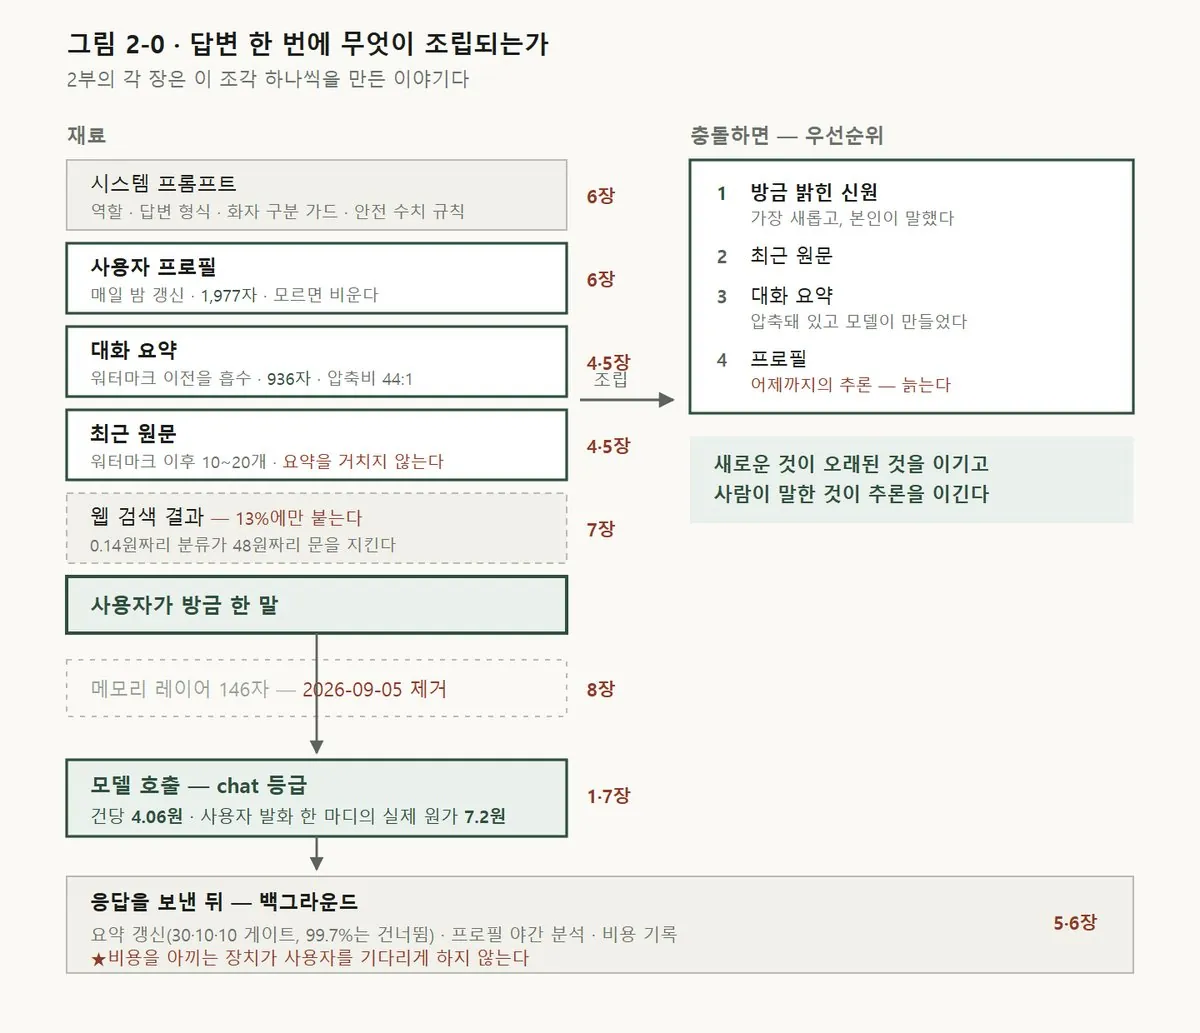
이 장은 그 조각 중 대화 요약과 최근 원문을 만든 기록이다. 이 서비스에서 기술적으로 가장 공들인 곳이고, 결과를 한 줄로 쓰면 이렇다.
메시지 144개짜리 대화 · 원문 41,294자
→ 실제로 모델에 보내는 것 4,518자 (11%)
순진한 해법 두 개
이 문제를 만나면 누구나 두 가지 중 하나를 먼저 한다. 나도 그랬고, 둘 다 실패했다.
첫째, 전부 보낸다. 대화 전체를 매번 넣는다. 처음엔 잘 된다. 그런데 세 가지가 동시에 나빠진다.
- 비용 — 입력 토큰은 보낸 만큼 낸다. 100턴 대화의 100번째 턴은 첫 턴보다 백 배 비싸다.
- 지연 — 4만 자를 읽고 답을 시작하는 데 걸리는 시간이 그대로 사용자의 대기 시간이 된다.
- 한계 — 모델마다 넣을 수 있는 최대치가 있고, 넘으면 그냥 실패한다.
특히 첫 번째가 고약하다. 대화가 길어질수록 비용이 선형이 아니라 제곱으로 는다. 매 턴마다 그때까지의 전부를 보내니까, 100턴 대화의 총비용은 1+2+3+…+100에 비례한다.
둘째, 최근 N턴만 보낸다. 가장 흔한 해법이고, 가장 흔한 실패다. 20개만 보내면 그 이전 이야기는 통째로 사라진다. 사용자는 이걸 즉시 알아챈다.
"아까 말했잖아요."
이 한마디가 챗봇을 죽인다. 사람은 AI가 틀리는 건 참아도 자기 말을 잊는 건 못 참는다. 앞에서 이름을 말했는데 뒤에서 다시 물으면, 그 순간 그건 대화가 아니라 창구가 된다.
우리가 쓴 구조
그래서 둘을 합쳤다. 오래된 것은 요약해서 압축하고, 최근 것은 원문 그대로 남긴다.
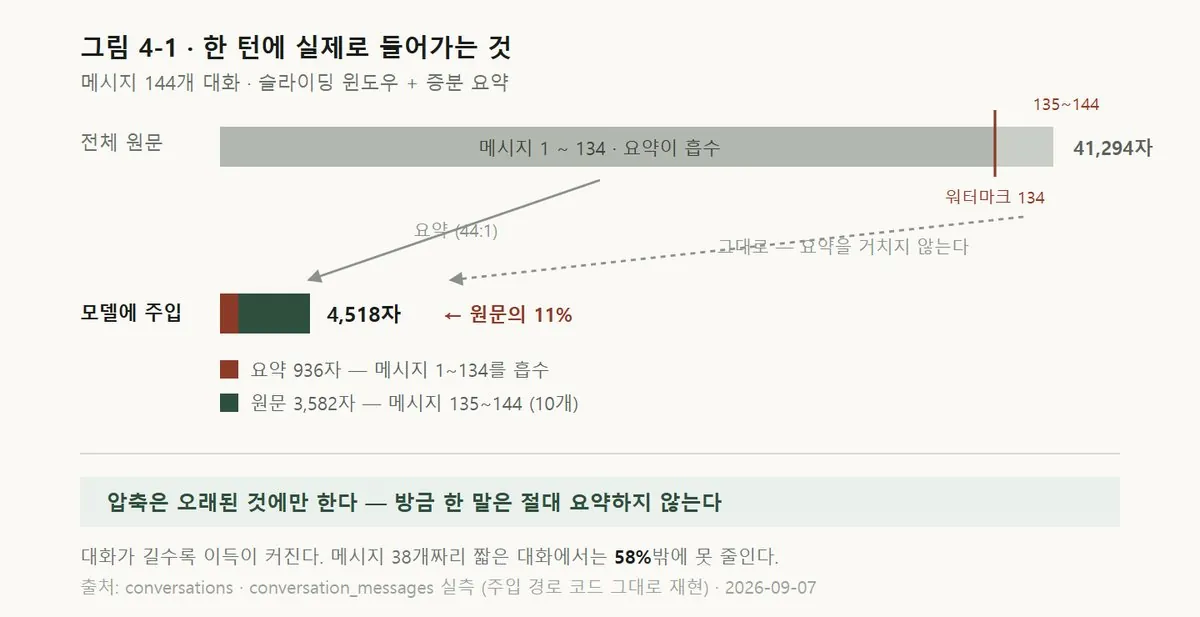
[ 메시지 1 ──────── 134 ]  [ 135 ─── 144 ]
       요약이 흡수한 구간        원문 그대로
            ↓                       ↓
         936자                  3,582자
            └─────────┬───────────┘
                모델에 4,518자
이 구조에는 이름이 있다 — 슬라이딩 윈도우 + 증분 요약이다. 최근 대화는 창처럼 뒤로 밀리며 원문을 유지하고, 창 밖으로 나간 것들은 요약에 흡수된다.
핵심은 '증분'에 있다. 요약을 매번 처음부터 다시 만들지 않는다. "몇 번째 메시지까지 이미 요약했는지"를 숫자 하나로 기록해 두고, 그 이후 것만 기존 요약에 합친다. 코드로는 이 한 줄이다.
raw_history = raw_history[until:] # 워터마크 이후만 원문으로
이 표식이 없으면 대화가 길어질 때마다 요약 비용도 같이 커진다. 짐을 덜려고 만든 장치가 다시 짐이 되는 것이다.
실측 — 가장 긴 대화
우리 서비스에서 가장 긴 대화는 메시지 144개, 주고받은 횟수로는 72번이다. 그 대화 하나를 뜯어보면 이렇다.
| 글자 수 | |
|---|---|
| 전체 원문 | 41,294자 |
| 요약 (메시지 1~134분) | 936자 |
| 원문 유지 (메시지 135~144, 10개) | 3,582자 |
| 실제 주입 | 4,518자 (원문의 10.9%) |
요약 하나만 보면 압축비가 44:1이다. 41,294자가 936자가 됐다.
이 두 숫자를 구분해서 봐야 한다. 44:1은 요약 자체의 압축률이고, 11%는 실제로 모델에 보내는 비율이다. 후자에 요약과 최근 원문이 둘 다 들어 있다.
요약이 있는 다른 대화들도 같이 보면 성격이 드러난다.
| 메시지 | 원문 | 요약 | 주입 비율 |
|---|---|---|---|
| 144개 | 41,294자 | 936자 | 11% |
| 70개 | 28,805자 | 951자 | 15% |
| 34개 | 20,269자 | 526자 | 44% |
| 38개 | 2,064자 | 203자 | 58% |
대화가 길수록 이득이 커진다. 38개짜리 짧은 대화에서는 58%밖에 못 줄인다. 압축은 길이에 비례해 값을 하고, 짧은 대화에서는 거의 의미가 없다. 이건 결함이 아니라 이 구조의 성질이다.
요약이 잃는 것
압축은 공짜가 아니다. 무엇을 잃는지 정확히 알아야 한다.
요약은 흐름을 남기고 표현을 버린다. "지난주에 아이가 열이 나서 걱정했고, 지금은 나았다"는 남지만, 그때 사용자가 쓴 정확한 단어와 말투는 사라진다. 그래서 우리 요약 프롬프트는 두 가지를 반드시 남기라고 지시한다 — 사실(이름·날짜·수치 같은 것)과 미해결 상태(사용자가 아직 답을 기다리는 것).
그리고 요약은 틀릴 수 있다. 요약도 모델이 하는 일이라 빠뜨리거나 왜곡한다. 그래서 최근 10개를 원문으로 남기는 것이 단순한 성능 타협이 아니다. 가장 최근의 맥락만큼은 요약을 거치지 않게 하는 안전장치다.
이 설계에서 나온 규칙 하나가 있다.
압축은 오래된 것에만 한다. 방금 한 말은 절대 요약하지 않는다.
실패해도 죽지 않는다
이 시스템에는 조용한 설계가 하나 더 들어 있다. 요약이 실패해도 대화는 계속된다.
요약은 사용자 응답이 나간 뒤에 백그라운드로 돈다. 그래서 요약이 실패하면 워터마크가 갱신되지 않을 뿐이고, 그 경우 원문 히스토리가 그대로 남는다. 그리고 그때를 대비해 마지막 방어선이 하나 더 있다.
if len(raw_history) > MAX_HISTORY:      # 20
    raw_history = raw_history[-MAX_HISTORY:]
요약이 정상이면 이 줄은 아무 일도 안 한다(원문이 이미 10~20개니까). 요약이 계속 실패해서 원문이 백 개로 불어나면, 이 줄이 20개로 자른다. 품질은 나빠지지만 서비스는 안 죽는다.
압축 장치는 실패했을 때 원래보다 나빠지지 않아야 한다.
이건 이 책 4부에서 계속 나오는 이야기이기도 하다. 자동화 장치를 붙일 때 물어야 할 첫 질문은 "잘 되면 얼마나 좋은가"가 아니라 "고장 나면 무엇이 남는가"다.
그런데 — 1,418개 중 4개다
여기서 이 장에서 가장 정직해야 할 대목이 나온다.
우리 서비스에는 대화가 1,418개 있다. 그중 요약을 가진 대화는 몇 개일까.
요약 보유 대화 4개 / 1,418개 = 0.3%
넷이다.
나머지 1,414개는 요약이 필요할 만큼 길어지지 않았다. 메시지 30개 미만에서 끝났기 때문이다. 그러니까 나는 1,418개 중 4개를 위해 이 시스템을 만들었다.
이 사실을 알았을 때 잠깐 허탈했다. 그런데 다시 보면 이게 정확히 요점이다.
실패는 평균에서 일어나지 않고 꼬리에서 일어난다. 대화 1,414개는 이 장치가 없어도 잘 돌아간다. 하지만 메시지 144개짜리 그 대화는, 이 장치가 없으면 매 턴 4만 자를 보내거나 앞부분을 통째로 잊는다. 그리고 그 한 사람이 서비스를 가장 열심히 쓴 사람이다.
가장 헤비한 사용자가 가장 먼저 깨진다. 평균 사용자를 기준으로 설계하면, 서비스를 제일 좋아하는 사람이 제일 먼저 나쁜 경험을 한다.
이건 이 책 전체를 관통하는 이야기이기도 하다. 2장의 이미지 비용도 세 명이 만들었고, 그중 한 명이 하루에 134장을 만들었다. 평균은 3장이었다.
비용
이 시스템을 돌리는 데 든 돈은 이렇다.
요약 호출 2회 $0.0024 ≈ 3원
넉 달 동안 3원이다. 요약은 메시지 30개에서 한 번, 그 뒤로는 10개마다 한 번만 돌기 때문에 호출 자체가 거의 없다. 그리고 요약을 만드는 데는 가장 싼 등급의 모델을 쓴다 — 요약은 창의성이 필요한 일이 아니기 때문이다.
그 3원이 아끼는 것은, 저 대화에서만 매 턴 3만 7천 자다.
정리하면
- 대화가 길어지면 비용이 제곱으로 늘고, 최근 것만 자르면 사용자가 즉시 알아챈다.
- 그래서 오래된 것은 요약, 최근 것은 원문으로 나눈다. 경계는 워터마크 숫자 하나로 관리한다.
- 원문 41,294자가 4,518자(11%)로 줄었다. 요약 자체는 44:1.
- 짧은 대화에서는 이득이 거의 없다. 압축은 길이에 비례해 값을 한다.
- 요약이 실패해도 서비스는 안 죽는다. 고장 나면 무엇이 남는가를 먼저 정했기 때문이다.
- 이 장치는 1,418개 중 4개를 위한 것이고, 그 4개가 가장 중요한 대화다.
다음 장에서는 이 시스템의 손잡이들을 뜯는다. 왜 30에서 시작하고, 왜 10을 남기고, 왜 10마다 도는가. 이 세 숫자는 감으로 정한 것이 아니다.