5장
요약은 언제 도는가 — 30·10·10의 근거
앞 장의 구조에는 손잡이가 셋 있다. 코드에서는 이렇게 생겼다.
SUMMARY_TRIGGER      = 30   # 메시지 30개부터 요약 시작
SUMMARY_KEEP_RECENT  = 10   # 요약 후 최근 10개는 원문으로 유지
SUMMARY_RUN_EVERY    = 10   # 마지막 요약 이후 +10개 쌓이면 재요약
이 장은 이 세 숫자가 왜 이 값인지, 그리고 바꾸면 무엇이 어떻게 변하는지에 대한 것이다. 그대로 복사해 쓸 수 있게 근거까지 적는다.
세 개의 게이트
요약 함수가 호출되면 가장 먼저 하는 일은 요약하지 않기로 결정하는 것이다. 게이트가 셋 있고, 하나라도 걸리면 그냥 돌아간다.
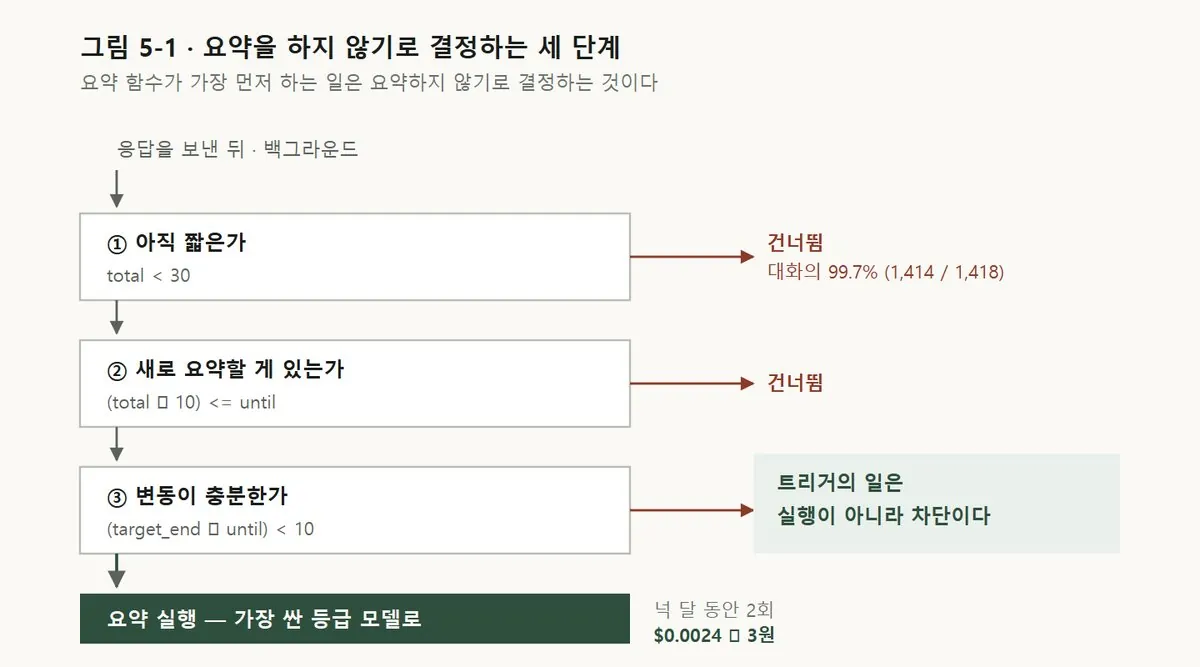
if total < SUMMARY_TRIGGER:              return False   # ① 아직 짧다
target_end = total - SUMMARY_KEEP_RECENT
if target_end <= until:                  return False   # ② 새로 요약할 게 없다
if (target_end - until) < RUN_EVERY:     return False   # ③ 변동이 작다
until은 앞 장에서 말한 워터마크 — 몇 번째 메시지까지 이미 요약했는지를 적어둔 숫자다.
이 세 줄이 이 시스템에서 가장 중요한 코드다. 요약을 잘 만드는 것보다 안 해도 될 때 안 하는 것이 비용과 품질 양쪽을 좌우하기 때문이다.
① 왜 30인가
트리거를 30으로 잡은 근거는 단순하다. 30개 미만이면 전부 넣어도 부담이 없다.
우리 대화의 메시지 평균 길이는 300자 안팎이다. 30개면 9천 자 정도이고, 이건 요즘 모델에게 아무 부담이 아니다. 그러니 그 아래에서 요약을 도는 것은 아끼는 것보다 쓰는 게 많은 일이다. 요약 호출 비용이 들고, 요약이 원문보다 부정확하고, 코드는 복잡해진다.
그런데 이 게이트의 진짜 성적표는 다른 데 있다.
전체 대화        1,418개
30개 이상 도달       4개
게이트 통과율      0.3%
이 한 줄이 99.7%를 걸러낸다.
여기서 이 장의 첫 번째 규칙이 나온다.
트리거의 일은 실행이 아니라 차단이다.
자동화 장치를 붙일 때 사람들은 "이게 얼마나 잘 도는가"를 본다. 실제로 봐야 할 것은 "이게 얼마나 안 도는가"다. 안 돌아야 할 때 도는 장치는 비용만 쓰는 게 아니라, 멀쩡한 것을 건드려서 망가뜨린다. 이 책 4부의 운영 에이전트도 정확히 같은 원리로 만들었다 — 이상이 없으면 모델을 아예 호출하지 않는다.
② 왜 10을 남기는가
KEEP_RECENT = 10. 요약을 만들 때 최근 10개는 대상에서 제외한다.
이건 4장에서 말한 안전장치다. 요약은 모델이 하는 일이라 틀릴 수 있으니, 가장 최근의 맥락만큼은 요약을 거치지 않게 한다.
숫자를 10으로 잡은 이유는 "방금 무슨 얘기 중이었는지"가 유지되는 최소 길이이기 때문이다. 메시지 10개면 주고받은 횟수로 다섯 번이다. 사용자가 질문하고, 답을 받고, 되묻고, 다시 답을 받고 — 그 정도의 왕복이 요약 없이 원문으로 남는다.
이 값을 움직이면 이렇게 된다.
| KEEP_RECENT | 결과 |
|---|---|
| 더 작게 (5) | 압축은 더 되지만, 요약이 잘못되면 바로 직전 맥락까지 오염된다 |
| 지금 (10) | 최근 다섯 번의 왕복이 원문으로 보장된다 |
| 더 크게 (20) | 안전하지만 압축 이득이 절반으로 준다 |
정확도가 걱정이면 올리고, 비용이 걱정이면 내린다. 다만 5 아래로는 권하지 않는다. 요약 실패가 곧바로 "아까 말했잖아요"가 되기 때문이다.
③ 왜 10마다 도는가
RUN_EVERY = 10. 마지막 요약 이후 새 메시지가 10개는 쌓여야 다시 요약한다.
이게 없으면 어떻게 되는지가 중요하다. 매 턴마다 재요약이 돈다. 그리고 증분 요약이라도 재요약에는 기존 요약과 새 메시지가 함께 들어가므로, 대화가 길어질수록 요약 호출 자체가 잦고 비싸진다. 짐을 덜려고 만든 장치가 새로운 짐이 된다.
10으로 잡은 것은 KEEP_RECENT와 짝이다. 이유는 다음 절에서 드러난다.
세 숫자가 함께 만드는 리듬
숫자 하나씩 보면 임의로 보인다. 대화가 자라는 과정에 대입하면 규칙이 보인다.
| 메시지 총수 | target_end | until | 판정 | 원문 유지 |
|---|---|---|---|---|
| 28 | — | 0 | ① 걸림 (30 미만) | 28개 |
| 30 | 20 | 0 | 요약 실행 → until=20 | 10개 |
| 35 | 25 | 20 | ③ 걸림 (5 < 10) | 15개 |
| 40 | 30 | 20 | 요약 실행 → until=30 | 10개 |
| 45 | 35 | 30 | ③ 걸림 | 15개 |
| 50 | 40 | 30 | 요약 실행 → until=40 | 10개 |
요약은 10개마다 정확히 한 번 돌고, 원문 유지분은 10과 20 사이를 오간다.
여기서 앞 장의 마지막 숫자가 제자리를 찾는다.
MAX_HISTORY = 20 # 주입 직전의 마지막 캡
정상 대역의 천장과 같은 값이다. 요약이 제때 돌면 원문은 10~20개이므로 이 캡은 아무 일도 하지 않는다. 이 캡이 실제로 작동했다는 것은 곧 요약이 밀렸다는 신호다.
마지막 방어선은 정상 대역의 경계에 놓는다. 그래야 그 선이 그어졌다는 사실 자체가 정보가 된다.
한참 위에 걸어두면(예: 100) 고장을 못 잡고, 대역 안에 걸어두면 정상 동작을 방해한다. 1장에서 주간 한도를 100만 원으로 걸어두고 아무것도 못 잡았던 것과 같은 이야기다.
언제, 무엇으로 도는가
두 가지가 더 있다. 둘 다 사용자 경험에 직접 닿는다.
첫째, 요약은 응답을 보낸 뒤에 돈다. 백그라운드 작업으로 넘긴다. 사용자는 요약이 도는지 모르고, 기다리지도 않는다. 만약 응답 경로 안에서 돌렸다면 30번째 메시지에서만 유독 답이 느려졌을 것이고, 사용자는 이유를 알 수 없었을 것이다.
비용을 아끼는 장치가 사용자를 기다리게 하면 안 된다.
둘째, 요약에는 가장 싼 모델을 쓴다. 요약은 창의성이 필요한 일이 아니라 압축하는 일이다. 우리 모델 등급표에서 가장 낮은 단계를 쓰고, 그래서 넉 달 요약 비용이 3원이었다.
기능마다 필요한 모델 등급이 다르다는 것 — 이게 채팅 건당 4원을 만든 실질적인 이유이고, 2부 끝에서 라우팅 전체를 다룬다.
당신 서비스에서 이 숫자를 정하는 법
그대로 복사해도 되지만, 서비스 성격이 다르면 조정해야 한다. 판단 기준만 정리한다.
TRIGGER — "요약 없이 전부 넣어도 감당되는 최대 길이"로 잡는다. 계산은 간단하다. 평균 메시지 길이 × N이 모델 입력의 부담이 되기 시작하는 지점. 우리는 9천 자였다.
KEEP_RECENT — "요약이 완전히 틀려도 대화가 이어지려면 원문이 몇 개 필요한가"로 잡는다. 주고받는 횟수로 3~5회분이 하한이다.
RUN_EVERY — 대개 KEEP_RECENT와 같게 두면 된다. 위의 리듬표가 그래서 깔끔하게 나온다. 비용이 더 급하면 올리되, 올린 만큼 원문 유지분의 상한도 같이 올라간다는 것을 잊으면 안 된다. RUN_EVERY를 30으로 올리면 원문은 10~40개를 오가고, MAX_HISTORY를 20으로 두면 그 캡이 정상 동작에서 작동하기 시작한다.
세 숫자는 따로 노는 손잡이가 아니라 하나의 리듬을 만드는 톱니다. 하나만 바꾸면 다른 데서 어긋난다.
정리하면
- 요약 함수가 가장 먼저 하는 일은 요약하지 않기로 결정하는 것이다. 게이트가 셋이다.
TRIGGER=30이 대화의 99.7%를 걸러낸다. 트리거의 일은 실행이 아니라 차단이다.KEEP_RECENT=10은 요약이 틀려도 최근 다섯 왕복은 원문이라는 보장이다.RUN_EVERY=10이 재요약 폭주를 막고, 이 둘이 만나 원문 유지분이 10~20을 오가는 리듬을 만든다.MAX_HISTORY=20은 그 정상 대역의 천장이다. 이 캡이 작동했다는 건 요약이 밀렸다는 뜻이다.- 요약은 응답 뒤에, 가장 싼 모델로 돈다. 그래서 넉 달에 3원이었다.
여기까지가 "기억을 어떻게 압축하는가"다. 다음 장은 다른 종류의 기억이다. 대화 안의 기억 말고, 사용자가 어떤 사람인지에 대한 기억 — 그리고 그 기억이 방금 한 말과 부딪힐 때 무엇을 믿을 것인가.