6장
프로필과 최신 발언이 충돌할 때
앞의 두 장은 대화 안의 기억을 다뤘다. 이 장은 다른 종류의 기억이다.
챗봇이 "쓸수록 나를 알아간다"고 말하려면, 대화 하나가 끝나도 남는 것이 있어야 한다. 사용자가 어떤 사람이고, 무엇을 하고 있고, 무엇을 신경 쓰는지 — 우리는 이걸 프로필이라고 부르고, 매일 밤 대화를 읽어 갱신한다.
프로필 주입 크기   약 1,977자
갱신 주기          매일 1회 (밤)
넉 달 분석 비용    65회 · 1,507원
답변할 때마다 이 1,977자가 시스템 프롬프트에 들어간다. 그래서 사용자는 어제 한 말을 오늘 다시 하지 않아도 된다.
그리고 이 기능이 이 서비스에서 가장 크게 사고를 냈다.
자기가 만든 거짓말을 자기가 배웠다
사고의 경위는 이렇다.
우리 서비스에는 가족끼리 아기 정보를 공유하는 기능이 있다. 그래서 챗봇은 어떤 대화에서 아기의 이름을 시스템 주입으로 알고 있었고, 답변에서 자연스럽게 그 이름을 불렀다.
밤이 되어 프로필 분석기가 그날 대화를 읽었다. 분석기는 대화록에서 이런 줄을 봤다.
[Riel] ○○이는 지금쯤 낮잠 잘 시간이겠네요.
그리고 이렇게 학습했다. "이 사용자는 ○○이를 양육 중이다."
다음 날부터 그 잘못된 프로필이 답변에 주입됐다. 챗봇은 더 확신을 갖고 그 사람을 아이 엄마로 대했고, 분석기는 그 답변을 다시 읽고 같은 결론을 더 굳게 학습했다.
AI가 자기 출력을 근거로 자기 자신을 오염시키는 루프가 만들어진 것이다.
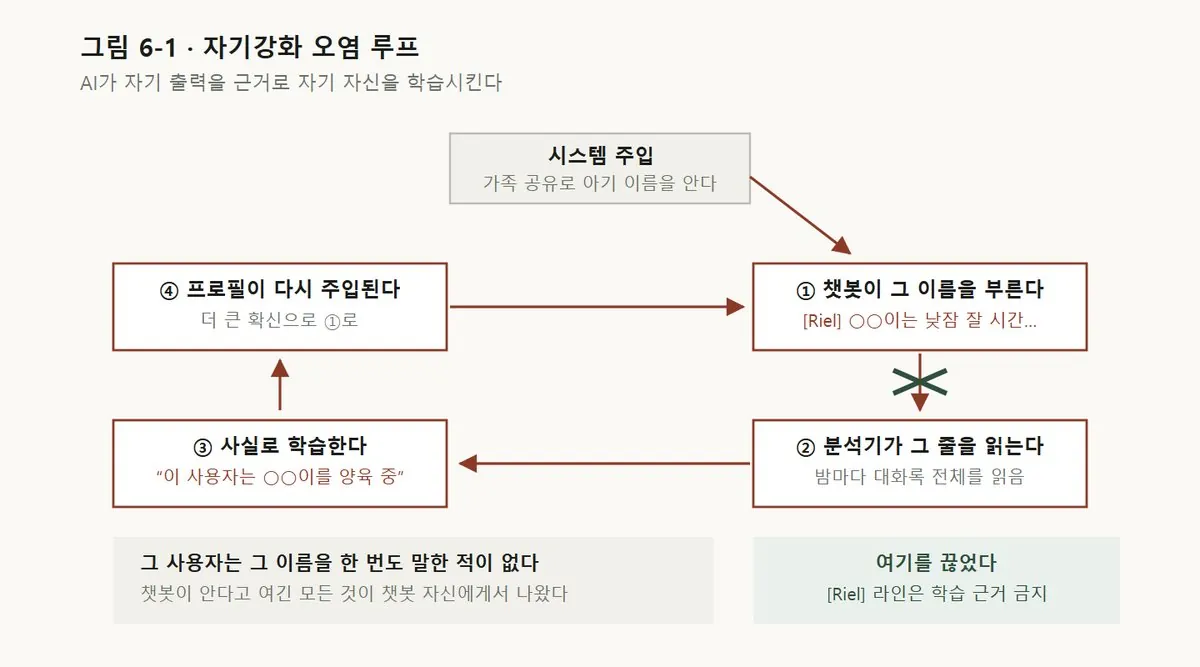
그런데 그 사용자는 그 이름을 한 번도 말한 적이 없었다. 아이를 직접 키우는 사람도 아니었다. 챗봇이 안다고 착각한 모든 것이 챗봇 자신에게서 나온 것이었다.
그래서 규칙은 하나로 좁아졌다
이 사고 뒤에 프로필 분석기의 첫 줄이 이렇게 됐다.
확실하지 않으면 학습하지 않는다.
그리고 그 밑에 구체적인 금지가 붙었다.
[Riel] 라인에 등장하는 이름·관계·가족·나이·직업은 학습 근거 금지.
그것은 이전 추론의 메아리거나 시스템 주입일 수 있다.
모든 근거는 [사용자] 라인에서만 찾아라.
AI의 발언은 대화 흐름을 이해하는 맥락일 뿐, 사실의 출처가 아니다. 당연해 보이지만, 대화록을 통째로 모델에게 넘겨 "이 사람에 대해 알아내라"고 시키면 기본적으로 이 구분이 없다. 모델에게 대화록은 그냥 텍스트다. 누가 말했는지는 라벨일 뿐이고, 모델은 라벨을 무시할 수 있다.
여기서 이 장의 첫 번째 규칙이 나온다.
AI의 출력을 다시 AI의 입력으로 넣을 때는, 그것이 사실이 아니라 출력이라는 표시가 살아 있어야 한다.
이건 챗봇에만 해당하는 이야기가 아니다. AI가 만든 것을 AI가 다시 읽는 구조는 요약, 자동 태깅, 문서 색인, 코드 생성 등 어디에나 있다. 그리고 그 고리는 조용히 강해진다 — 틀린 쪽이 매번 더 확신에 차기 때문이다.
학습의 문턱을 두 겹으로
금지만으로는 부족했다. 무엇을 배울지에도 문턱을 세웠다. 지금 규칙은 이렇다.
둘 다 만족해야 학습한다.
- 사용자가 1인칭·소유격으로 명시했는가 — "저는 ○○입니다", "제가 ○○중인데", "우리 아기"
- 같은 사실이 두 번 이상 등장했거나, 사용자가 직접 자기소개를 했는가
그리고 이것들은 학습 금지다.
- "친구가 / 조카가 / 지인이 / 학생이 / 이웃이" 같은 제3자 신호가 붙은 정보
- 사용자가 직접 말하지 않은 고유명사와 관계
- 모호한 모든 것 — 애매하면 빈 값을 넣는다
마지막 줄이 핵심이다. 프로필 분석기는 모르면 모른다고 적는다. 추측해서 채우면 그 추측이 내일 답변의 전제가 되고, 사용자는 그것을 정정할 방법이 없다.
사용자에 대한 기억은, 틀린 것보다 비어 있는 것이 낫다.
없으면 챗봇은 그냥 물어보면 된다. 틀리면 물어보지도 않고 확신한다.
사용자가 직접 고칠 수 있어야 한다
그래도 틀린다. 그래서 마지막 층이 하나 더 있다. 사용자가 직접 입력한 정정이 모든 추론을 압도한다.
정정 블록이 있으면 그것이 유일한 최상위 사실이다.
대화에서 무엇이 보이든, 기존 프로필에 무엇이 있든,
정정과 모순되는 추론은 전부 폐기한다.
앞의 사고를 이 규칙으로 다시 보면 이렇게 된다. 사용자가 "나는 이 아이를 키우지 않는다"고 한 줄 적으면, 분석기는 그날 대화에서 반대 신호를 백 개 봐도 그 한 줄을 따른다.
AI가 자기 자신을 고칠 수는 없다. 사람이 고칠 수 있는 문을 만들어 둬야 한다.
답변할 때의 규칙 — 최신이 이긴다
여기까지가 프로필을 만드는 쪽 이야기다. 프로필을 쓰는 쪽에도 규칙이 필요하다.
답변 시스템 프롬프트에는 화자 구분 절이 따로 있고, 그 안에 이 책에서 가장 짧고 중요한 문장이 들어 있다.
프로필 주입과 충돌하면 최신 발언이 우선. 프로필을 의심하세요.
이유는 단순하다. 프로필은 늙는다. 어제까지의 대화로 만든 요약이고, 오늘 사용자가 하는 말이 그 요약을 갱신하기 전이다. 그 사이에 사용자가 "저 이번에 이직했어요"라고 하면, 프로필의 직업란은 그 순간 틀린 것이 된다.
그래서 답변 규칙은 이렇게 정리된다.
| 순위 | 근거 | 이유 |
|---|---|---|
| 1 | 사용자가 방금 명시한 신원 | 가장 새롭고, 본인이 직접 말했다 |
| 2 | 최근 대화 원문 | 요약을 거치지 않은 맥락 |
| 3 | 대화 요약 | 압축돼 있고 모델이 만들었다 |
| 4 | 프로필 | 어제까지의 추론 |
새로운 것이 오래된 것을 이기고, 사람이 말한 것이 AI가 추론한 것을 이긴다. 두 축이 같은 방향을 가리킨다.
그리고 — 물어봐도 된다
화자 구분 절의 마지막 항목이 흥미롭다.
진짜 모호하면 답변 시작 부분에서 한 번만 물어보세요 —
"이건 본인 경험인가요, 아니면 다른 분 이야기인가요?"
단, 매번 묻지 말고 답변 방향이 크게 달라질 때만.
되묻는 것을 허용하되, 남발을 금지한다. 이 두 문장이 같이 있어야 한다. 앞줄만 있으면 챗봇은 매번 확인만 하다 대화를 끝내고, 뒷줄만 있으면 모르는 채로 단정한다.
이건 실제 사고에서 배운 것이다. "ADHD 약 부작용"이나 "임플란트 절차" 같은 질문을 받으면 챗봇은 그것을 사용자 본인의 일로 단정하고 사연을 붙여 답했다. 정보만 원한 사람에게 그건 불쾌한 참견이다. 그래서 지금 규칙은 본인 일이 명확히 드러나지 않은 정보 질문은 중립적인 일반 정보로 답한다이다.
정리하면
- 프로필은 대화 밖에 남는 기억이고, 매일 갱신되며 답변마다 약 1,977자가 주입된다.
- AI가 자기 출력을 학습해 스스로를 오염시키는 루프가 실제로 생겼다. 챗봇이 부른 이름을 분석기가 사실로 배웠다.
- 그래서 AI 발언은 학습 근거에서 제외하고, 1인칭 명시와 2회 반복이라는 두 문턱을 세웠다.
- 모호하면 비운다. 사용자에 대한 기억은 틀린 것보다 비어 있는 것이 낫다.
- 사용자가 직접 쓴 정정이 모든 추론을 압도한다. AI는 스스로를 못 고친다.
- 답변할 때는 최신 발언이 프로필을 이긴다. 프로필은 늙기 때문이다.
- 모호하면 되물어도 되지만, 한 번만.
이 장의 규칙들은 전부 "무엇을 기억할 것인가"에 대한 것이었다. 다음 장은 그 반대다. 우리는 이것 말고 또 하나의 기억 장치를 만들었다가, 재보고 지웠다.